距离10月30日还有两周,Meta的一纸新商用条款,正把全球新闻业推向新的十字路口。据AI Weekly报道,Meta最新商业使用条款允许其通过网络爬虫收集与平台关联的商业账户网站内容,用于训练包括Meta AI在内的产品,且未提供退出选项。在"授权付费"与"自主抓取"双轨并行的策略之下,一场围绕新闻内容产权与AI训练数据边界的争夺战正全面升级。
一、条款生效在即:商业账户网站内容默认纳入AI训练
据AI Weekly及国内媒体转载报道,Meta最新商业使用条款将于10月30日正式生效。新条款显示,Meta将利用网络爬虫,收集与其平台"关联"的商业账户相关网站内容,并明确这些内容将用于训练其产品,包括Meta AI助手。
条款的适用范围相当宽泛:凡拥有商业账户的新闻出版商及其他企业——包括管理页面、投放广告及使用商业仪表板的账户——均被纳入其中。更关键的是,截至10月30日,商业账户没有任何退出选项:条款规定,若不同意新约定,用户需停止所有商业目的的产品访问或使用。换言之,出版商要么选择相信Meta不会严格按字面执行条款,要么只能停用商业账户。
《The Steampunk Explorer》创始人斯蒂芬·比尔(Stephen Beale)表示,正考虑在条款生效日前关闭账户以示抗议。
二、"测试凭据"与"搭售"质疑:藏在服务条款里的访问权
新条款中包含创建"测试凭据"的规定。法律专家指出,这一设计在技术上可能允许Meta注册"假用户",从而绕过出版商设置的付费墙访问内容;针对测试凭据问题,Meta拒绝置评。
律师马特·托皮克(Matt Topic)批评称,该条款等于赋予Meta访问"潜在价值数百万美元材料"的权限,而这一切都隐藏在服务条款之中。法学教授詹姆斯·格里梅尔曼(James Grimmelmann)认为,在广义解释下,Meta可利用出版商内容建立档案库,甚至可能与出版商形成竞争关系。法学教授本杰明·索贝尔(Benjamin Sobel)则指出,将商业产品访问权与广泛爬取权限捆绑,涉嫌反垄断法中的"搭售",且与谷歌要求出版商同意内容用于"AI概览"的政策类似。
面对质疑,Meta发言人回应称,此次更新只是整合分散的条款,并未改变未来的爬取方式,内容所有者仍可通过robots.txt协议管理爬虫访问。值得注意的是,新条款紧随Meta付费订阅服务Meta One推出之后——该服务限制了非订阅用户发布外部链接的数量。
三、双轨策略:一手授权付费,一手争议缠身
此次条款收紧并非Meta在新闻内容上的第一次落子。事实上,Meta正同时走两条路线:一条是"付费授权",另一条是"自主抓取"。
在授权一侧,Meta已与新闻集团(News Corp)签署多年期AI内容授权协议,期限至少三年,新闻集团每年将因此获得最高5000万美元收入;根据协议,Meta可以使用新闻集团在美国和英国的内容,为其AI产品用户检索最新信息,并利用新闻存档等内容训练AI模型。新闻集团首席执行官罗伯特·汤姆森(Robert Thomson)在摩根士丹利一场会议上透露,公司正在进行的其他谈判已进入"后期阶段"。此外,Meta方面表示已与People Inc.、《今日美国》、CNN和福克斯新闻(Fox News)等多家公司达成协议,但具体条款均未披露。据国内行业媒体报道,Meta AI的回复已开始附上CNN、福克斯新闻台等媒体的原文链接。
【图表:已披露科技巨头与媒体AI内容授权协议年价值对比】
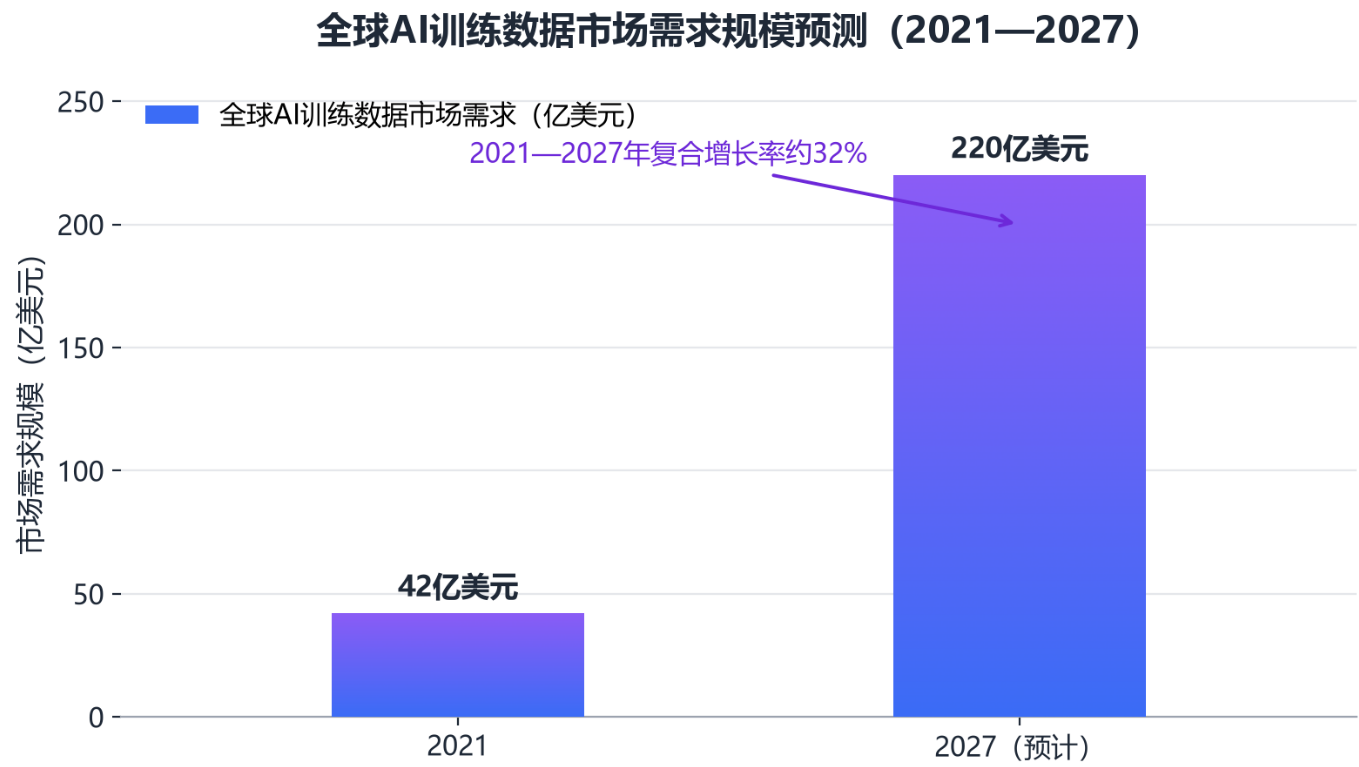
从已披露金额看,新闻集团与Meta的协议年价值最高可达5000万美元,与新闻集团此前和OpenAI签署的五年期、总价值超2.5亿美元的协议(折算年均约5000万美元)处于同一量级;纽约时报公司与亚马逊的授权协议年价值约为2000万美元至2500万美元。头部媒体的内容授权费已形成数千万美元级的"行情",为出版商与平台谈判提供了定价参照。
在自主抓取一侧,Meta的争议从未间断。Meta专门有用于扒取视频内容的爬虫MSAE,Meta AI自己承认其训练数据包含370万条YouTube视频转录文本的第三方数据集。2026年1月,包括h3h3 Productions在内的几位YouTube博主在加州中区联邦法院起诉Snap,指控其将数百万条YouTube视频批量下载用于训练数据集;原告伊桑·克莱因(Ethan Klein)同时把英伟达、Meta、字节跳动、亚马逊、OpenAI、苹果一并告上法庭,理由是这些公司"一天能抓走80年的内容"。
Meta同时面临多起版权集体诉讼。在Kadrey诉Meta案中,13位知名作家指控Meta从"影子图书馆"下载受版权保护的书籍训练Llama大语言模型;法院虽以原告未能证明市场替代损害为由作出有利于Meta的阶段性裁决,但案件仍在推进,Meta正面临该集体诉讼的审理,新条款下的训练实践也将持续受未决诉讼影响。此前,阿歇特(Hachette)、麦克米伦(Macmillan)、麦格劳希尔(McGraw Hill)、爱思唯尔(Elsevier)等五大出版商组成联盟起诉Meta,诉状直指其行为构成"史上规模最大的版权侵权",并将首席执行官马克·扎克伯格列为被告,指控其"亲自批准并主动纵容"侵权行为。
四、深层动因:语料枯竭焦虑与"毁灭循环"之忧
平台为何执意"圈占"新闻内容?答案指向AI产业的底层焦虑——高质量训练数据正在枯竭。
Epoch AI测算,全球公开人类文本语料的耗尽窗口中位数约为2028年。与此同时,多家机构口径显示,2026年至2032年全球AI训练数据相关市场年复合增速将达20%至35%。更早的Cognilytica统计显示,2021年全球AI训练数据市场需求约为42亿美元,预计2027年将增长至220亿美元,复合增长率达32%。为锁定数据供给,Meta此前以150亿美元入股数据公司Scale AI,后者估值达290亿美元。
【图表:全球AI训练数据市场需求规模预测(2021—2027)】
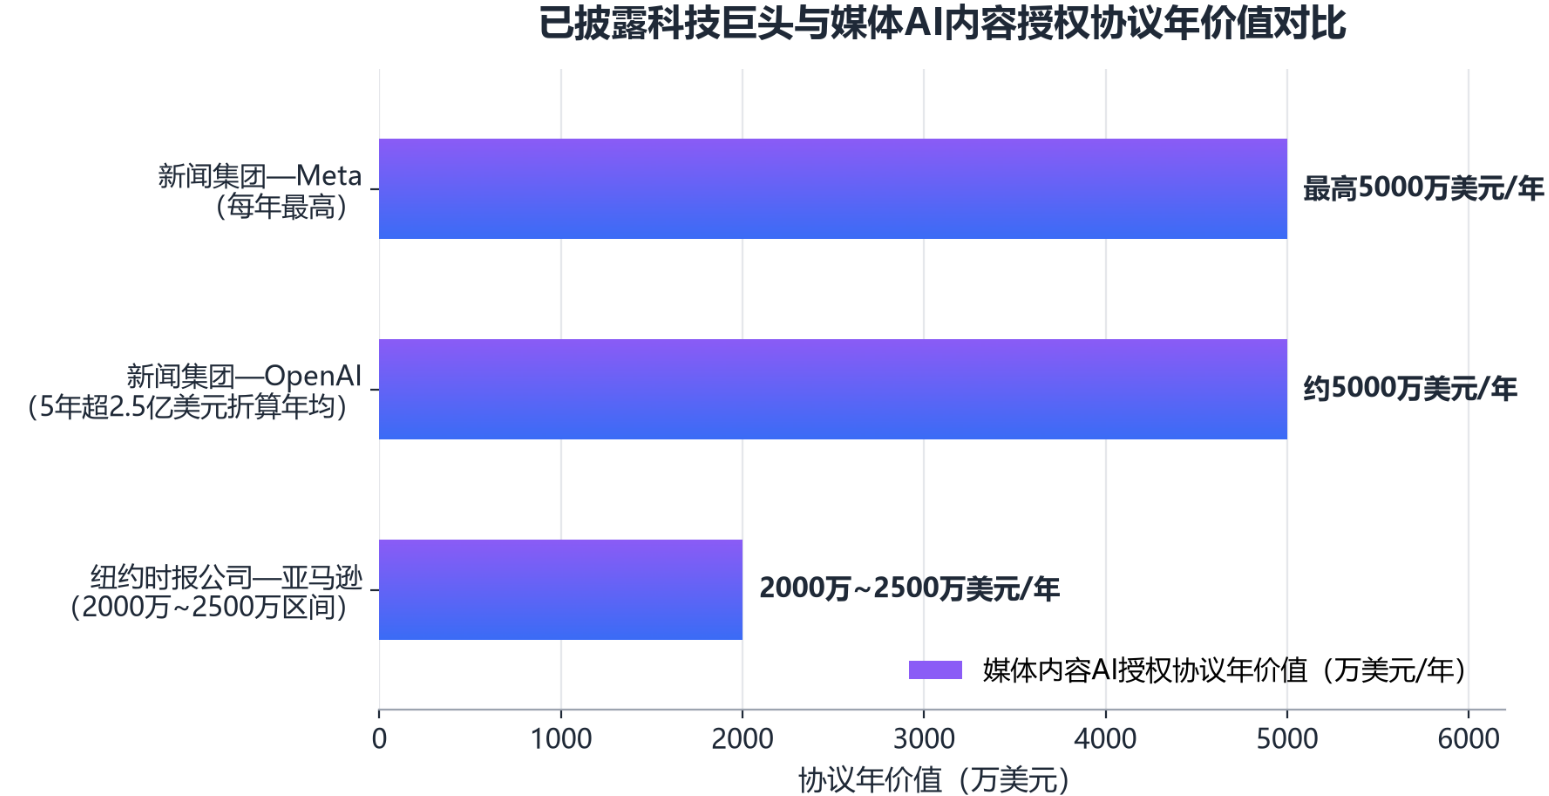
从2021年的约42亿美元到2027年预计的220亿美元,全球AI训练数据市场需求六年间预计增长逾四倍。当公开语料逼近耗尽、数据需求仍在扩张,新闻媒体积累的高质量、权威、持续更新的文本内容,自然成为平台争相锁定的"燃料"。
数据焦虑之外,AI产品对新闻业的"流量反噬"也在被内部数据证实。2026年9月披露的微软及OpenAI内部文件显示,微软应用科学部门主管布伦特·赫克特(Brent Hecht)曾警告,将新闻内容用于AI训练是"前所未有的大规模盗窃",甚至可能是"人类历史上规模最大的劳动力盗窃"。文件还提出"毁灭循环(doom loop)"风险:AI产品不断减少新闻网站流量和收入,导致新闻机构减少内容生产,AI模型本身最终失去可靠信息来源。微软内部数据显示,部分涉诉新闻机构的点击率下降了83%至93%,另一些机构下降了51%至94%。微软CEO萨提亚·纳德拉(Satya Nadella)作证时承认,聊天机器人直接提供信息,相当于"从新闻网站那里拿走了点击量";ChatGPT负责人尼克·特利(Nick Turley)亦在内部确认,让AI产品具备取代新闻提供商的能力,可能给出版商带来"生存性威胁"。
【图表:微软内部数据显示的涉诉新闻机构网站点击率下降区间】
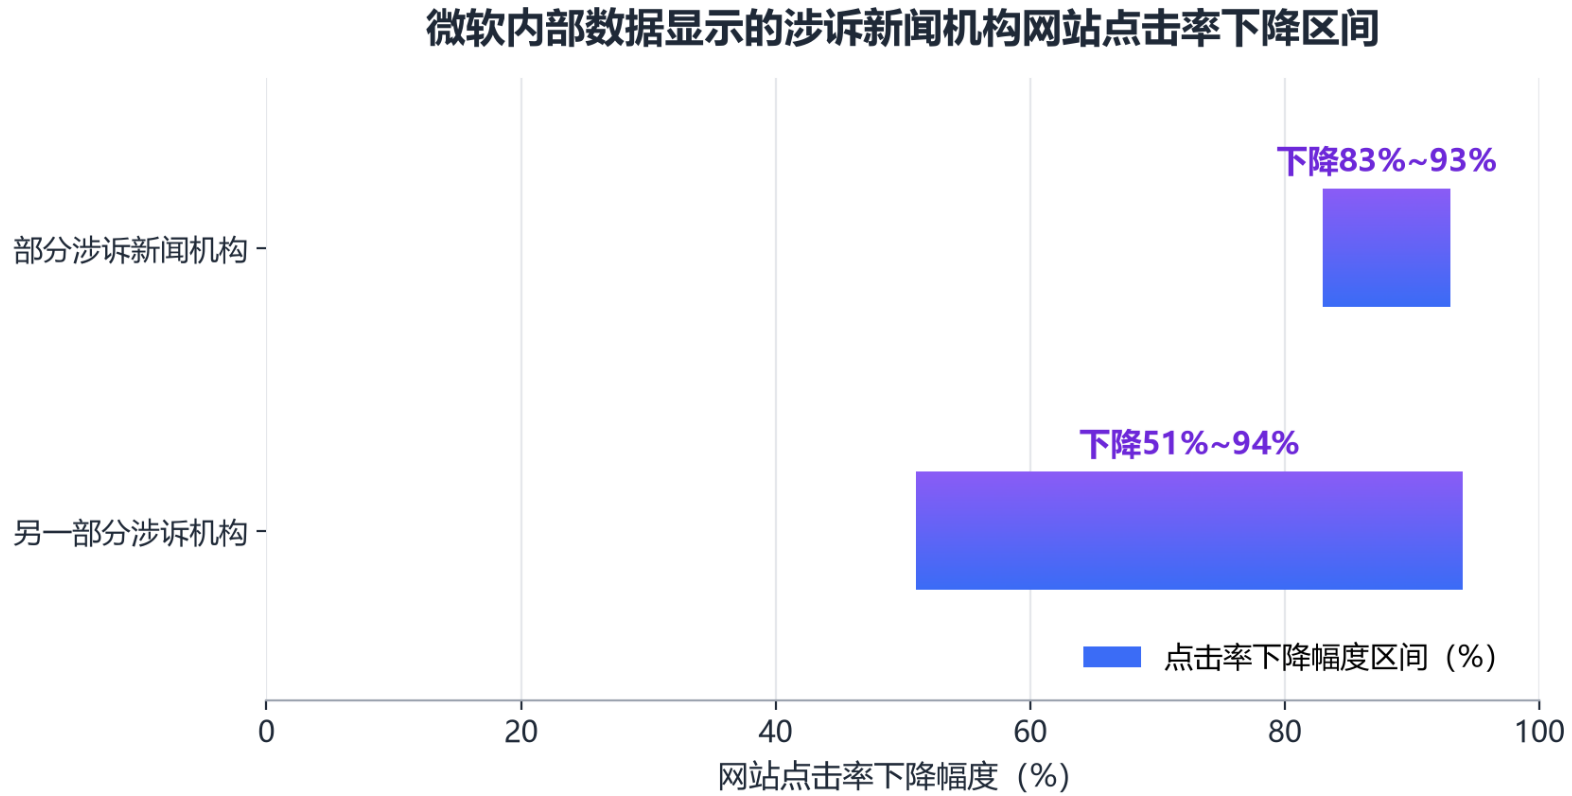
微软内部数据显示,涉诉新闻机构网站点击率降幅最高达94%,最低亦超过一半。流量与收入的塌缩,正是出版商对"默认抓取"条款反应激烈的根本原因——如果内容被免费抓取、用户又不再点击原文,新闻业的商业模式将失去支点。
五、司法与监管坐标:合理使用分歧下的收紧信号
"默认抓取"能否站得住,最终取决于司法与监管的态度,而目前各方规则远未统一。
在美国,2025年6月,Meta与Anthropic曾在两起独立案件中赢得部分胜利,法官表示,在某些情况下提取受版权保护的材料来训练AI模型属于合理使用。Meta此前也曾向美国版权局辩称,模型通过训练接触大量文本来"学习"语言,"就像孩子通过听日常讲话、睡前故事、收音机里的歌曲等来学习语言一样"。风投机构Andreessen Horowitz则警告,将版权责任成本强加给AI模型创造者,"要么会扼杀、要么会严重阻碍其发展"。
但合理使用的边界并不清晰。Bartz诉Anthropic案中,法院对"训练本身"持开放态度,却对"盗版来源与长期保存副本"更为严格,Anthropic最终达成15亿美元和解——美国史上最大版权和解;Getty Images诉Stability AI案指控其非法复制超1200万张图片。德国法院在GEMA诉OpenAI案(2025年11月)中判定原告胜诉,与美国司法倾向形成鲜明对比。"绕过网站反爬虫协议(robots.txt)或付费墙、大规模抓取内容用于训练"明确列为典型侵权风险场景。互联网档案馆创始人布鲁斯特·卡勒(Brewster Kahle)感叹,围绕抓取行为的诉讼与不明确的界限"可能会让美国的AI公司倒退,这不是一个重要行业的运作方式"。
监管层面,信号同样在收紧。2026年9月30日,美国联邦贸易委员会(FTC)证实正在调查OpenAI、Anthropic等AI研发机构,审查其技术可能给消费者带来的风险及相关行为是否违反《联邦贸易委员会法》,并计划正式要求相关机构提供信息、强制高管作证;FTC主席安德鲁·弗格森此前接受路透社采访时表态,反对将AI智能体视为具有独立意志的行为主体,开发者应对其造成的损害承担责任。AI Weekly本期报道即聚焦"FTC想要OpenAI和Anthropic的安全事件记录"。此前一日,白宫与多家科技企业高管会面,企业同意建立自愿性AI安全标准。更早之前,已有两名美国议员提出《人工智能基础模型透明法案》,要求所有AI基础模型披露训练数据来源与获取方式;欧洲议会也已以压倒性票数通过《人工智能法案》,欧盟官员将其称为"世界上第一部针对可信人工智能的全面、具有约束力的法规"。中国经济学者盘和林指出,各国对训练数据获取的法规尚有分歧甚至空白,共识在于不能涉及个人隐私数据,企业爬取公共数据需进行脱敏脱密处理。
六、出版商的抉择与内容生态走向
站在10月30日的门槛前,出版商手中的选项其实相当有限:继续依赖robots.txt这道"君子协定",接受条款并寄望Meta自我克制,效仿斯蒂芬·比尔关闭商业账户,或者加入新闻集团、纽约时报公司的行列——一边谈授权、一边打官司。新闻集团旗下已有两家子公司以侵犯版权为由起诉Perplexity;纽约时报公司在起诉OpenAI和微软的同时,与亚马逊签署了年价值2000万美元至2500万美元的AI授权协议。"授权加诉讼"的双轨打法,正在成为新闻业的集体生存策略。
值得注意的是,与谷歌要求出版商同意内容用于"AI概览"的政策类似,Meta的新条款意味着:不进入AI训练数据池的内容,可能同时失去在平台生态中的分发位置。对新闻业而言,这已不只是版权问题,而是关乎分发权与生存空间的博弈。
10月30日之后,三个观察点值得关注:其一,是否真有出版商以关户、技术屏蔽等方式抵制;其二,Kadrey案等未决诉讼的走向,将直接影响Meta"按条款训练"的法律成色;其三,FTC等行业监管机构的后续动作。在司法、监管与商业模式三重变量交织之下,新闻内容与AI训练数据的产权边界正在被重新划定——而这一次,用的是条款、诉状与监管函,而非技术协议。