9月21日,2026人工智能计算大会(AICC2026)在北京中关村国际创新中心举行。会上,浪潮信息发布元脑SD200 Ultra超节点AI服务器:该产品基于本土AI芯片,以开放系统设计紧耦合128芯,单机可承载运行2.8万亿参数的Kimi K3大模型,Token生成时延首次降至5.85毫秒以内,并支持10万亿参数规模前沿模型单机运行;单用户Token生成速度约170 tokens/s,达到业界平均水平的5倍。同期,浪潮信息还发布了面向规模化智能供给的元脑HC2000多元算力机组。
这款新品的发布,恰逢全球AI算力支出处于历史性扩张窗口——Gartner预计2026年全球AI支出将达2.7万亿美元,同比增长49.5%;TrendForce亦在8月将2026年全球AI服务器出货量增速预测从28%上调至近31%。在超节点从"产品元年"走向"规模放量"的产业节点上,SD200 Ultra的落地意味着中国AI算力基础设施的竞争维度,已从单芯片性能转向系统级工程能力的全面较量。
一、事件直击:AICC2026上的"双线发布"
AICC2026于2026年9月21日在北京中关村国际创新中心举行。在这场年度AI计算产业风向标式的盛会上,浪潮信息首席AI战略官刘军系统阐述了Agent时代的AI计算产业变革判断:随着智能体加速从对话工具走向生产实践,AI计算产业正迎来从"提供算力"到"生产智能"的范式转变,衡量计算系统价值的标尺,也从"有多少算力"转向"能支撑多强的智能、以多低的成本生产多少智能"。
基于这一判断,浪潮信息提出了两条并行的产品主线。其一是面向智能前沿的能力型智算(Capability AI Compute),支撑突破智能上限,回答"智能究竟可以有多强";其二是面向智能普及的容量型智算(Capacity AI Compute),实现智能充分供给,回答"我们能以多低成本获得多少智能"。此次发布的元脑SD200 Ultra超节点AI服务器,正是能力型智算赛道的旗舰之作;而元脑HC2000多元算力机组,则承担容量型智算的规模化供给任务。
刘军在演讲中进一步指出,浪潮信息的定位正从"算力设备提供商"向"智能生产系统服务商"升级,通过软硬件一体化优化,帮助客户屏蔽底层硬件差异,降低多元本土AI芯片的使用门槛;未来浪潮将坚持开放协同路线,联合芯片、模型、软件等产业链伙伴,共同探索Agent时代的计算架构。这一"双线布局+生态协同"的叙事,为SD200 Ultra的发布提供了完整的战略注脚。
二、产品解析:SD200 Ultra的核心参数突破
从官方披露的规格看,SD200 Ultra在多项关键指标上实现了对上一代产品的代际跃升:
● 互联规模:采用3D Hyper Mesh架构,以开放系统设计紧耦合128芯本土AI芯片;
● 内存能力:提供8TB统一编址显存和64TB内存;
● 模型承载:单机承载运行2.8万亿参数的Kimi K3大模型,并支持10万亿参数规模前沿模型单机运行;
● 推理时延:Token生成时延首次突破5.85毫秒,相当于单用户速度170 Tokens/s,达到业界平均水平的5倍;
● 通信性能:原生内存语义通信时延低至0.69微秒;通过对称内存技术首次在基于本土AI芯片的超节点上实现GPU显存直连,AllReduce通信时间降低3.5倍;
● 算子优化:算子数量降低10倍,通过"K3优化K3"实现Kimi K3推理性能提升3倍以上。
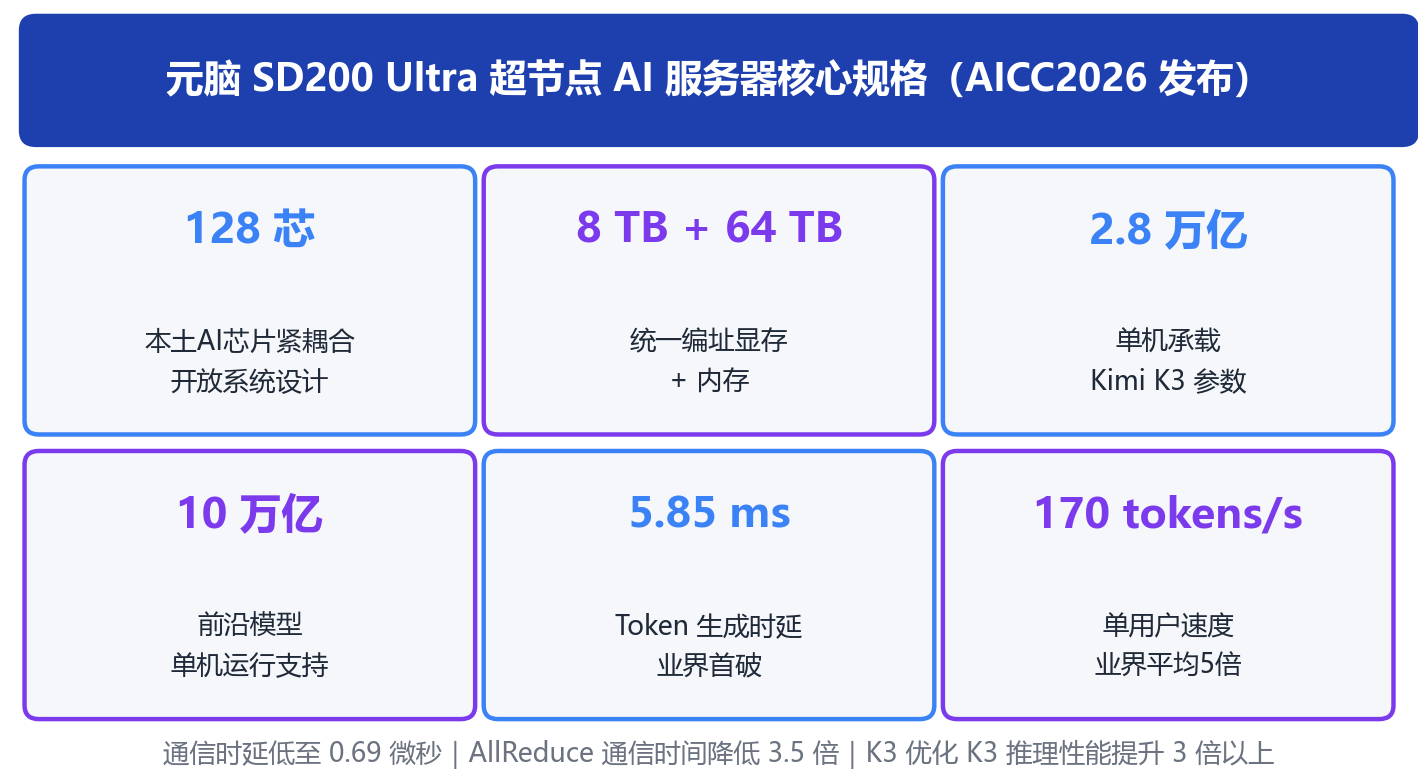
图1 元脑SD200 Ultra核心规格
对照上一代产品,这轮升级的跨度清晰可见。2025年8月发布的元脑SD200,在单机内实现64路本土GPU芯片统一寻址与高速互连,最大可承载4万亿参数模型;而SD200 Ultra将互联规模翻倍至128芯,显存统一编址规模提升至8TB,并首次将"支持10万亿参数级前沿模型单机运行"写入了产品能力边界。
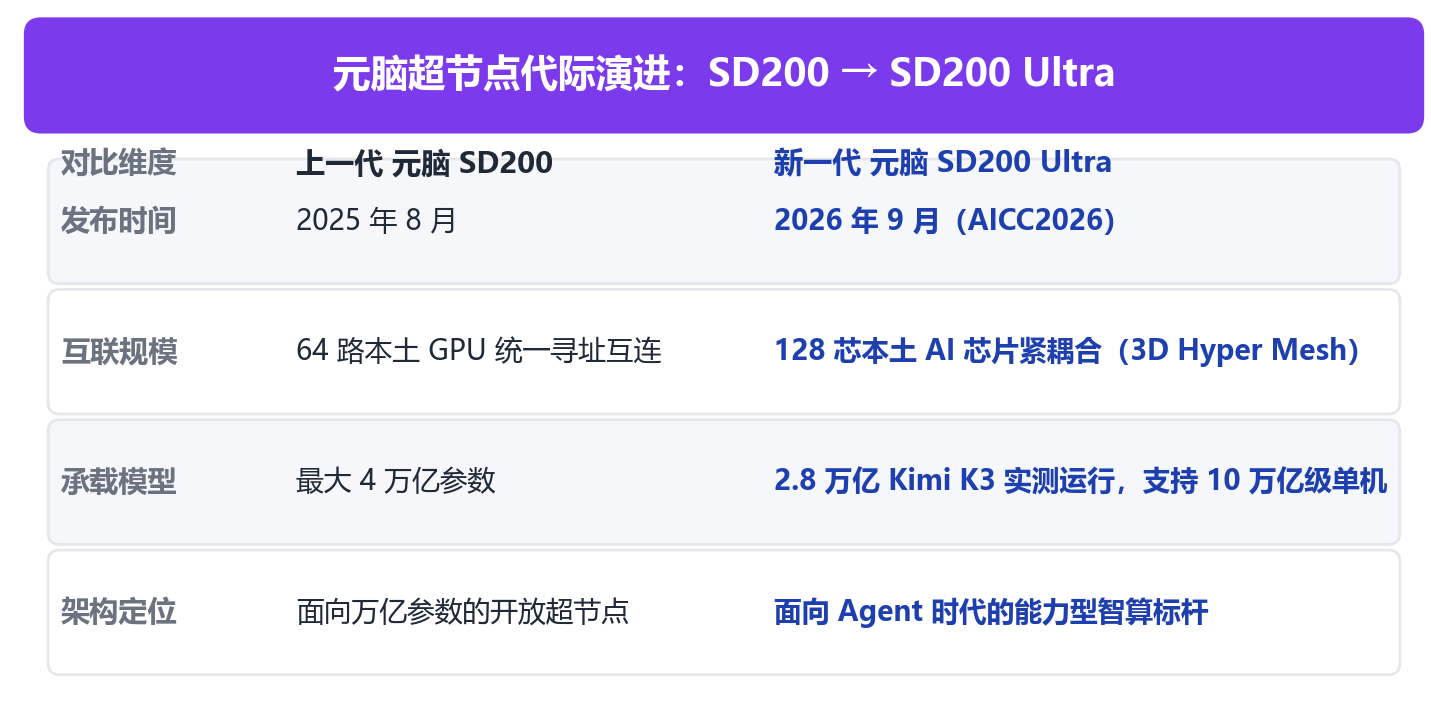
图2 元脑超节点代际演进
三、架构拆解:开放系统设计为何紧耦合128芯
超节点的本质,是通过高速互连将尽可能多的计算资源整合为一个逻辑统一的"计算域",以系统级创新突破单芯片的性能边界与单服务器的通信瓶颈。这已成为全球AI算力产业的共识性方向——2025年被业内视为超节点产品元年,英伟达GB200 NVL72自2025Q2起大规模出货,超节点形态正成为AI算力基础设施的新常态。根据TrendForce等咨询机构预估,2025年Blackwell GPU占英伟达高阶GPU出货比例80%以上,超节点出货的GPU占比约50%,超节点形态将成为高端智算中心的主流基础设施。
在这一背景下理解SD200 Ultra的技术路线,可以看到三个鲜明的工程选择:
第一,紧耦合的3D Hyper Mesh架构。 前沿模型参数规模、上下文长度持续增长,复杂智能体任务需要承载更大的模型权重、缓存与运行状态,传统服务器集群受限于跨节点通信延迟,难以高效支撑。超节点的核心价值在于通过统一内存寻址构建协同计算域,以对称直连、算子优化等方式减少数据搬移与等待时间。SD200 Ultra以3D Hyper Mesh架构将128芯本土AI芯片纳入同一高速互连域,正是这一逻辑的工程化落地。
第二,开放系统设计。 与封闭生态不同,SD200 Ultra延续浪潮信息在开放计算路线上的积累。其上一代产品元脑SD200即基于OCM与OAM(开放加速器模组)两大开放计算架构打造,采用多主机低延迟内存语义通信架构与开放总线交换技术。开放路线的产业意义在于:在英伟达NVLink生态之外,为本土多元AI芯片提供了兼容并蓄的系统底座,使不同技术路线的芯片得以在同一系统中分工协作。
第三,短距铜缆互连与统一寻址。 SD200 Ultra采用短距铜缆互连设计减少光电转换环节,降低链路故障引发任务中断的风险;通过全局统一编址、虚拟影子设备映射、跨域地址翻译与路由,实现GPU跨主机域的统一寻址访问,构建百纳秒级低时延的内存语义互连域——远端资源访问从传统的"消息通信与数据搬移"转变为统一地址空间下的直接访问。
对Agent时代而言,这些架构特性直接对应三项刚性需求:跟上模型参数从千亿级向十万亿级的扩张速度、满足实时决策场景对低时延的要求、支撑复杂智能体任务连续数小时乃至数天的长稳运行。
四、模型协同:当2.8万亿参数的Kimi K3遇上超节点
SD200 Ultra选择Kimi K3作为单机承载的标杆模型,颇具产业象征意义。2026年7月17日,月之暗面正式推出Kimi K3:这是一个2.8万亿参数模型,基于KDA混合线性注意力机制和注意力残差技术构建,原生支持视觉理解,拥有100万token上下文窗口,是全球首个开源的3万亿级别模型。
模型规模的跃迁直接改写了算力部署的规则。Kimi K3官方建议采用64张及以上加速卡组成超节点部署,对AI硬件需求同步扩大;而在浪潮信息的官方叙事中,前沿模型参数规模已从DeepSeek R1的6710亿增长到Kimi K3的2.8万亿,并进一步走向10万亿级,上下文从128K扩展到1M以上。传统8卡服务器的节点内带宽已难以承载万亿参数模型的权重、KV Cache与并发运行状态,超节点由此从"可选项"变为"必选项"。
SD200 Ultra单机承载2.8万亿参数Kimi K3的能力,与Kimi K3官方建议的"64卡以上超节点部署"形成呼应:一方面,它验证了本土AI芯片超节点对超大规模前沿模型的单机承载能力;另一方面,它为开源大模型社区提供了一个可对标、可复制的本土算力运行环境。在国产开源模型与国产算力系统之间,"软硬协同优化"正在成为双向奔赴的产业趋势。
五、性能深挖:5.85毫秒背后的全链路优化
5.85毫秒的Token生成时延,是SD200 Ultra最具传播力的指标,但其背后的系统工程逻辑更值得关注。官方通稿将其归因于"对系统架构、通信机制、算子等全方位优化",具体展开为四层:
其一,紧致扩展。 3D Hyper Mesh架构紧耦合128芯,提供8TB统一编址显存与64TB内存,为超大规模模型与超长上下文提供充足的键值缓存空间;短距铜缆互连降低链路故障风险,支撑长程Agent任务稳定运行。
其二,统一寻址。 全局统一编址使远端资源访问变为统一地址空间下的直接访问,从机制上降低通信开销。
其三,对称直连。 对称内存技术首次在本土AI芯片超节点上实现GPU显存直连——GPU能够像访问本地显存一样直接访问远端GPU显存数据,直接发起通信、减少地址转换、避免缓冲区中转,AllReduce通信时间降低3.5倍。
其四,超级算子。 这是最具创意的一环:针对Kimi K3的推理特点,浪潮信息"用Kimi K3构建超级算子智能体",率先在本土AI芯片超节点上实现通算融合、Tile级流水的超级算子,将KDA、Gated MLA、MoE中的众多基础算子融合为计算与通信协同执行的大算子——算子数量降低10倍,大幅减少算子启动次数与HBM访问开销,最终通过"K3优化K3"实现Kimi K3推理性能提升3倍以上。
将时间维度拉长,这条性能曲线的爬升轨迹更为直观:2025年8月发布的上一代元脑SD200,曾率先完成对Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等主流领先开源大模型的软硬协同性能优化,并在万亿参数模型推理中展现出毫秒级的Token生成能力;此次SD200 Ultra则在2.8万亿参数的Kimi K3上实现5.85毫秒时延——模型规模上一个台阶,时延仍被牢牢锁定在毫秒级区间,系统级创新的"性能红利"清晰可见。
六、市场纵深:AI算力支出进入"万亿美元时代"
SD200 Ultra的发布窗口,正值全球AI算力市场的历史性扩容期。多家权威机构的最新预测勾勒出这条陡峭的增长曲线:
全球维度:Gartner预计2026年全球AI支出将达2.7万亿美元,同比增长49.5%;其中AI基础设施支出近1.5万亿美元,约占总支出的56%。此前Gartner亦预计2026年全球数据中心系统支出将超7880亿美元,增速远超此前预期。TrendForce数据显示,谷歌、亚马逊、Meta、微软、甲骨文、字节跳动、腾讯、阿里、百度九大云服务商2026年资本开支合计将超8867亿美元,同比增长约90%;其中中国四大云服务商(字节、腾讯、阿里、百度)资本开支合计同比增长超80%。TrendForce据此将2026年全球AI服务器出货量增速预测从28%上调至近31%。
中国维度:IDC数据显示,2025年上半年中国加速服务器市场规模达160亿美元,同比增长220%;预计2029年中国加速服务器市场规模将超1400亿美元。竞争格局方面,2025年上半年中国加速服务器市场按销售额计,浪潮、宁畅、新华三位居前三,CR3接近50%;按出货台数计,浪潮、宁畅、华为位居前三,约占43%份额;互联网厂商仍是最大采购方,占整体市场超69%。需求结构上,2024年国内AI服务器工作负载中推理占比已达65%,IDC预计到2028年这一比例将升至73%——推理主导的时代,正是SD200 Ultra这类推理优化型超节点的用武之地。此外,IDC预计中国智能算力规模将从2022年的259.9 EFLOPS增长至2027年的1117.4 EFLOPS,年均复合增长率达33.9%。
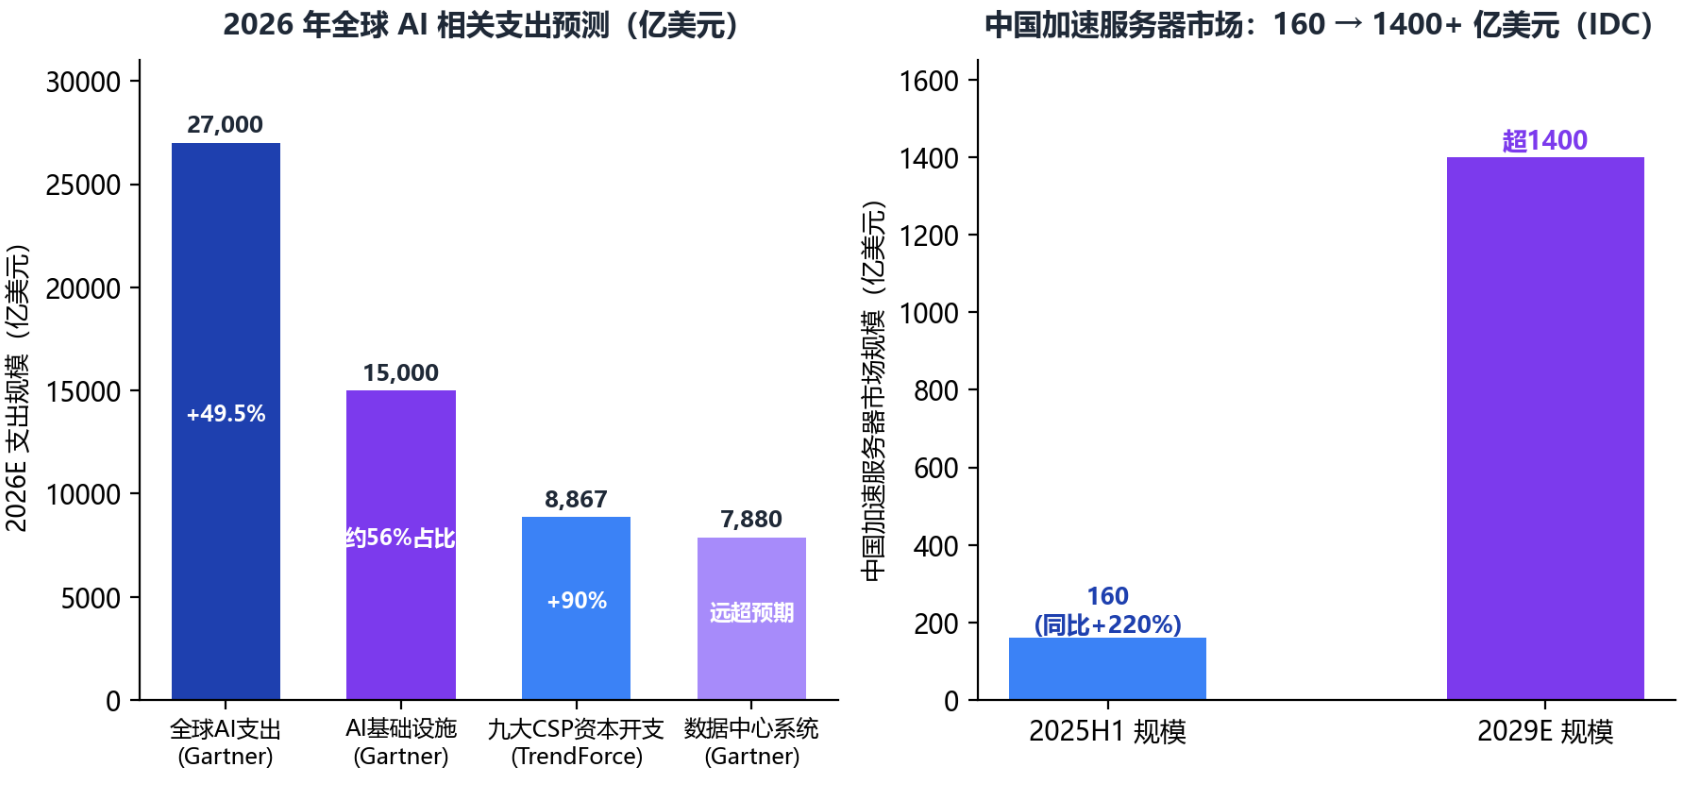
图3 全球与中国AI算力市场关键预测
市场逻辑与产品逻辑在此形成闭环:Agent应用普及推动Token需求爆发式增长,Token需求驱动推理算力占比持续提升,推理算力需求又倒逼AI基础设施从"堆卡"走向"超节点"。超节点由此成为AI算力产业从训练竞赛转向推理普及阶段的核心基础设施形态。
七、竞争格局:全球超节点路线竞逐
把SD200 Ultra放入全球坐标系,可以看到超节点赛道已经形成了多条技术路线并行竞逐的格局:
英伟达路线:GB200 NVL72以机架级液冷设计连接36个Grace CPU和72个Blackwell GPU,构成单一NVLink高速域,自2025Q2起大规模出货,树立了垂直整合模式的标杆。其互联协议闭源,追求端到端的最优性能,但用户面临厂商锁定与成本高企的现实约束。
华为路线:华为Atlas 950超节点最大可连接8192张NPU卡,真机已于2026年7月17日至20日在2026世界人工智能大会期间亮相。此前发布的CloudMatrix384超节点集群以384颗昇腾芯片为基本单元,系统级BF16算力达到英伟达GB200 NVL72的1.7倍,总内存容量为其3.6倍,总内存带宽为其2.1倍——以系统级规模优势弥补单卡性能差距的路线已得到验证。
国产多元阵营:2025年以来,国产超节点呈现密集发布态势——阿里磐久AL128超节点128卡、字节大禹超节点64/128卡、腾讯ETH-X开放超节点64卡、百度天池超节点256/512卡、中科曙光scaleX640单机柜640卡等产品相继落地。行业研究显示,超节点已成为国产算力破局的核心载体,通过高速总线将数十乃至数百颗芯片整合为逻辑统一的高带宽域,从根本上缓解通信墙与内存墙的双重瓶颈。
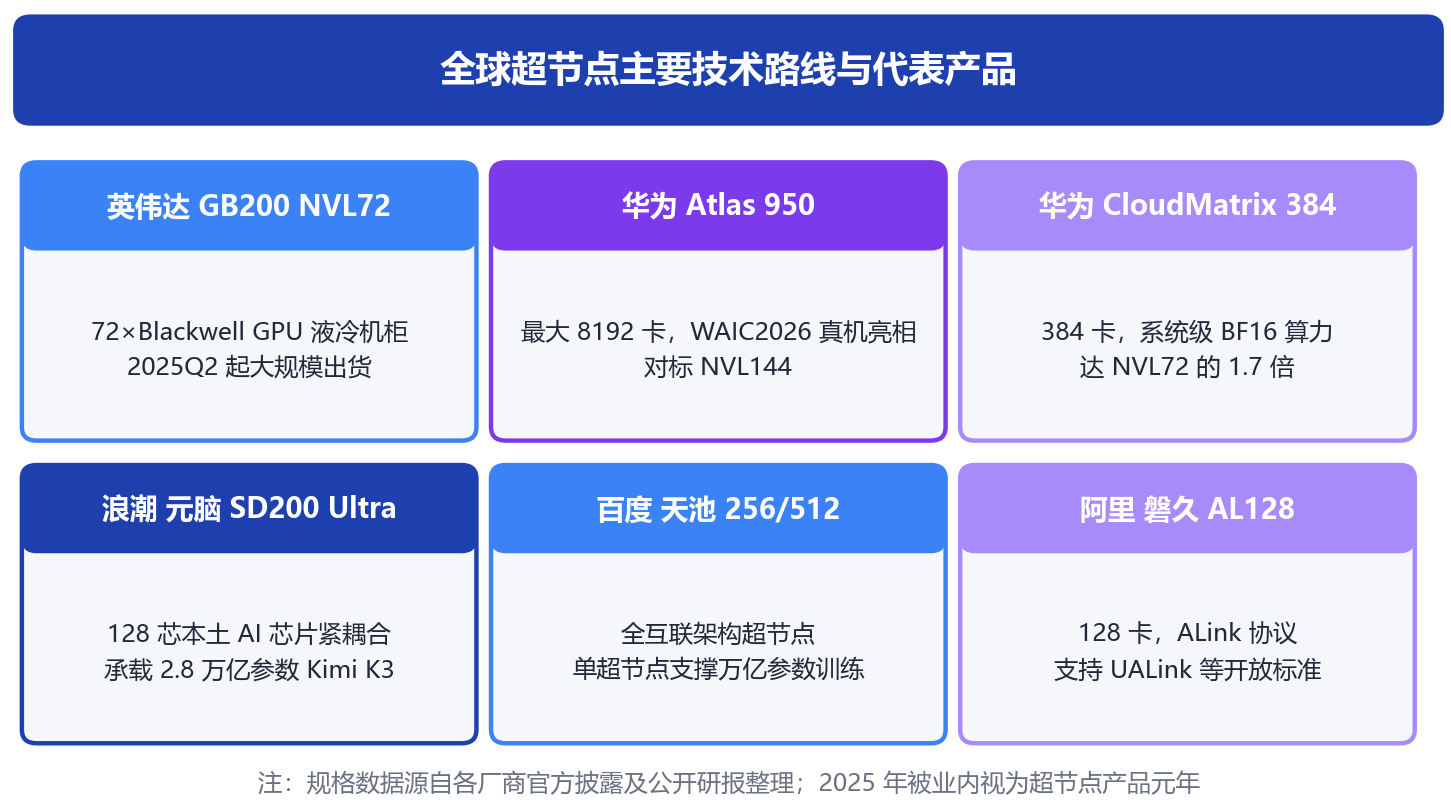
图4 全球超节点主要技术路线
在这幅竞争版图中,SD200 Ultra的差异化定位在于三点:其一,128芯的互联密度在已发布的开放架构超节点中处于第一梯队;其二,"开放系统设计+紧耦合"的组合既保留了开放生态的兼容性,又达到了接近垂直整合的耦合深度;其三,与头部开源模型的深度协同——率先完成对Kimi K3的适配优化并以"K3优化K3"实现性能跃升,为"国产模型+国产算力"的协同范式提供了样板。
需要指出的是,超节点竞争的本质已从"造出更强的单颗芯片"转变为"高效组织起更多芯片"的系统工程能力较量。2025年的超节点产品元年之后,2026年国产AI超节点正进入规模化应用阶段,竞争焦点将进一步转向互联协议生态、软件栈成熟度与规模交付能力。
八、HC2000与多元算力:容量型智算的另一翼
如果说SD200 Ultra解决的是"智能能有多强",那么同步发布的元脑HC2000多元算力机组,回答的则是"智能能否足够便宜、足够充足"。
规格层面,HC2000采用DirectCom 2.0极速架构,单柜供电能力达300kW以上,最大承载256张AI加速卡;实测数据显示,在相同服务水平约束下,该系统同等投资的Token产能提升10倍。这一指标直指Agent时代最尖锐的成本矛盾:随着智能体普及,Token需求呈爆发式增长,单纯堆砌同类型算力无法匹配推理各环节的差异化负载,也难以兼顾成本与效率。
从产品脉络看,HC2000是浪潮信息容量型智算产品线的延续与升级。此前推出的元脑HC1000超扩展AI服务器基于全对称DirectCom极速架构,以无损超扩展设计聚合海量本土AI芯片、支持极大推理吞吐量。HC2000进一步引入MCIS推理软件栈,实现计算负载按需匹配、动态优化的多元算力机组形态。
"多元算力"四个字的分量,需要放在本土AI芯片生态的现状中理解。当前国产AI芯片呈现"百芯齐放"格局,不同芯片的技术路线、软件栈各不相同,客户直接使用门槛高。刘军强调,多元算力的意义不只是兼容不同芯片,更是让不同技术路线的产品在同一系统中分工协作、优势互补,共同做大智能供给的蛋糕。这与产业研究机构的判断相互印证:协议开放模式正以"兼容性"和"选择权"对抗封闭性,成为超节点生态竞争的另一条主线。
SD200 Ultra与HC2000的组合,由此构成"突破前沿—普及落地—产生新需求—推动再突破"的完整闭环:能力型智算不断拓展智能能力边界,容量型智算让高水平智能可负担、可持续,两者共同驱动智能经济发展。
九、业绩印证与行业展望:从"提供算力"到"生产智能"
超节点产品的密集迭代,正在转化为龙头厂商的真金白银。浪潮信息2026年半年度报告显示:公司上半年实现营业收入843.79亿元,同比增长5.22%;归母净利润29.52亿元,同比大增269.59%;扣非净利润24.19亿元,同比增长260.08%。分季度看,公司2026Q2单季度实现营业收入489.08亿元,同比增长47%,业绩明显加速——实际净利增速落于此前业绩预告的226%至288%区间之内。此前披露的2025年年报显示,公司全年实现营业收入1647.82亿元,同比增长43.58%;归母净利润24.13亿元,同比增长5.28%。
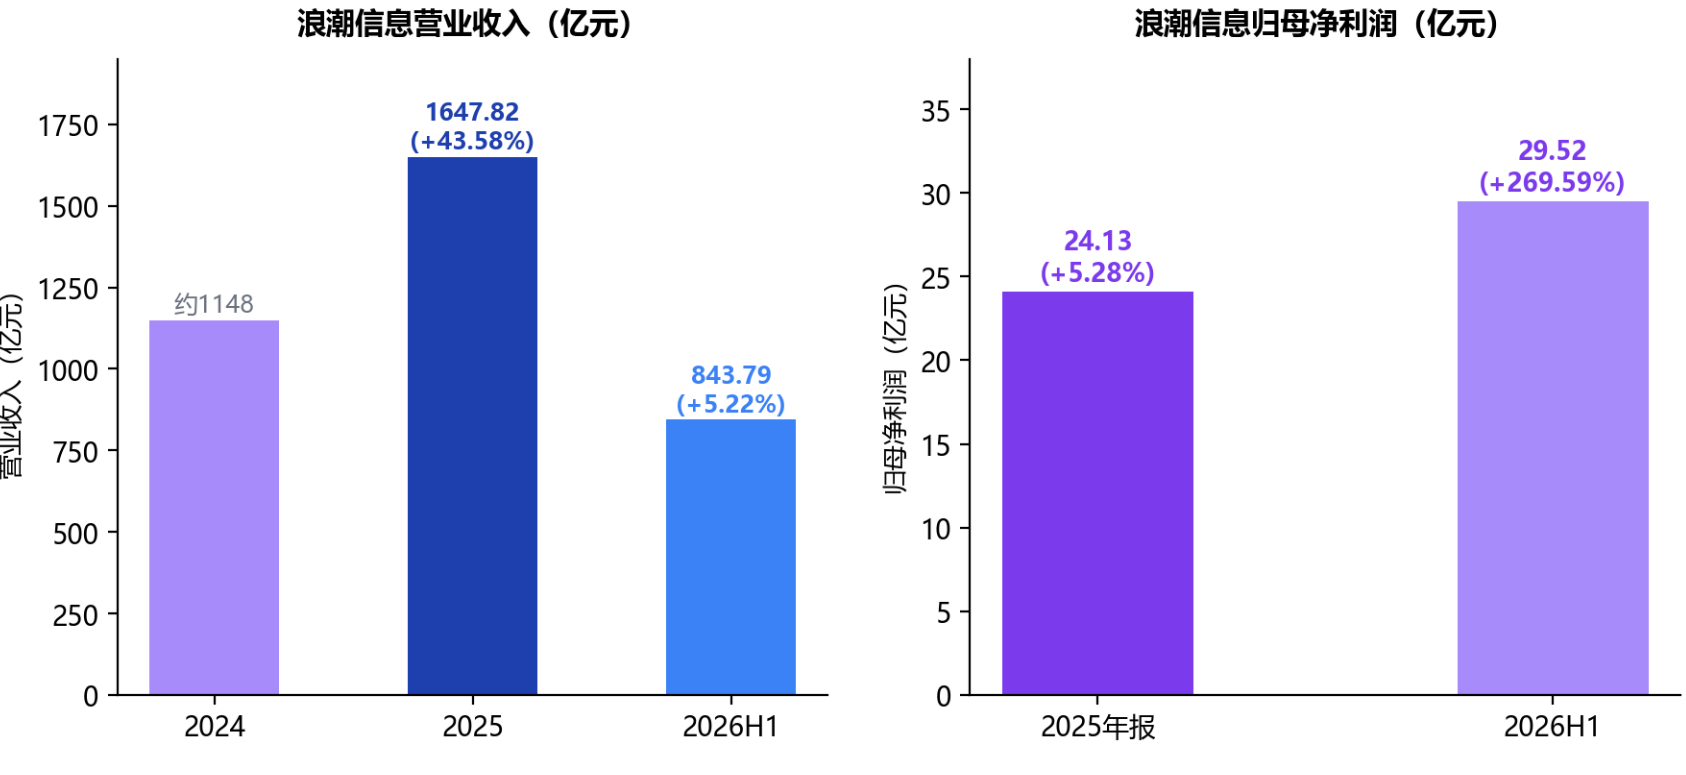
图5 浪潮信息业绩表现
从"营收微增、利润倍增"的结构看,AI服务器特别是超节点等高价值产品的盈利弹性正在释放。行业层面,AI服务器市场仍处于高景气周期,叠加超节点进入规模化商用阶段,带动高速连接、液冷等配套环节协同发展。
站在产业视角,SD200 Ultra的发布可以放在三重趋势中解读:
趋势一:算力竞争的"系统级"转向不可逆。 从单芯片性能比拼转向全栈系统能力与产业生态的较量,已成行业共识。128芯紧耦合、统一内存寻址、对称直连、超级算子——SD200 Ultra的每一项创新都指向系统级工程能力。当单芯片制程受限时,系统创新成为突破智能上限的主要路径。
趋势二:推理主导时代的"双维度"分化。 2024年推理已占国内AI服务器负载的65%,且将持续提升至2028年的73%。对应地,AI计算分化为能力型与容量型两大方向——前者以SD200 Ultra为代表突破智能上限,后者以HC2000为代表降低智能供给成本。产品线的"双子星"结构,将成为AI服务器厂商的标准竞争姿态。
趋势三:开放生态与软硬协同的价值重估。 SD200 Ultra与Kimi K3的深度协同展示了"模型优化算子、算子反哺模型"的新范式;开放系统设计则为多元本土AI芯片提供了共同的舞台。在AI市场空间足够大、产业并非零和博弈的判断下,开放协同路线有望汇聚更广泛的产业力量,推动中国AI计算产业在系统级竞争中占据有利身位。
正如官方通稿所言:从"提供算力"走向"生产智能",浪潮信息将持续推进贯穿式系统创新,让更强的智能能力以可负担的成本进入更多企业和行业应用。Agent时代的大幕正在拉开,而超节点,正是这个时代最重要的算力基础设施形态之一。