1. 天垓300 IXL144超节点首展 天数智芯算力产品线覆盖云端到端侧
2. 全球首款搭载脑机接口的AI眼镜,Looktech新品发布
3. AI缺货潮还有2至3年 内存恐率先降温?陈立武示警
4. 应材50亿美元 EPIC 中心揭幕 魏哲家:加速2纳米之后技术走向量产
5. 英特尔、博通齐发警告:资本或成AI扩张最大瓶颈
6. 明年百万颗!微软2nm AI芯片官宣:每瓦算力自称比GPU高40%
1. 天垓300 IXL144超节点首展 天数智芯算力产品线覆盖云端到端侧
10月12日至16日,2026中国工博会集成电路展(国芯展)在上海举行。上海天数智芯半导体股份有限公司(下称“天数智芯”)携天垓300 IXL144超节点、天垓300 GPU、彤央TY1200边缘AI算力终端等多款产品参展,其中,天垓300 IXL144超节点为首次公开亮相。值得一提的是,展会期间,彤央TY1200获颁CIIF 2026国芯展创新成果奖。
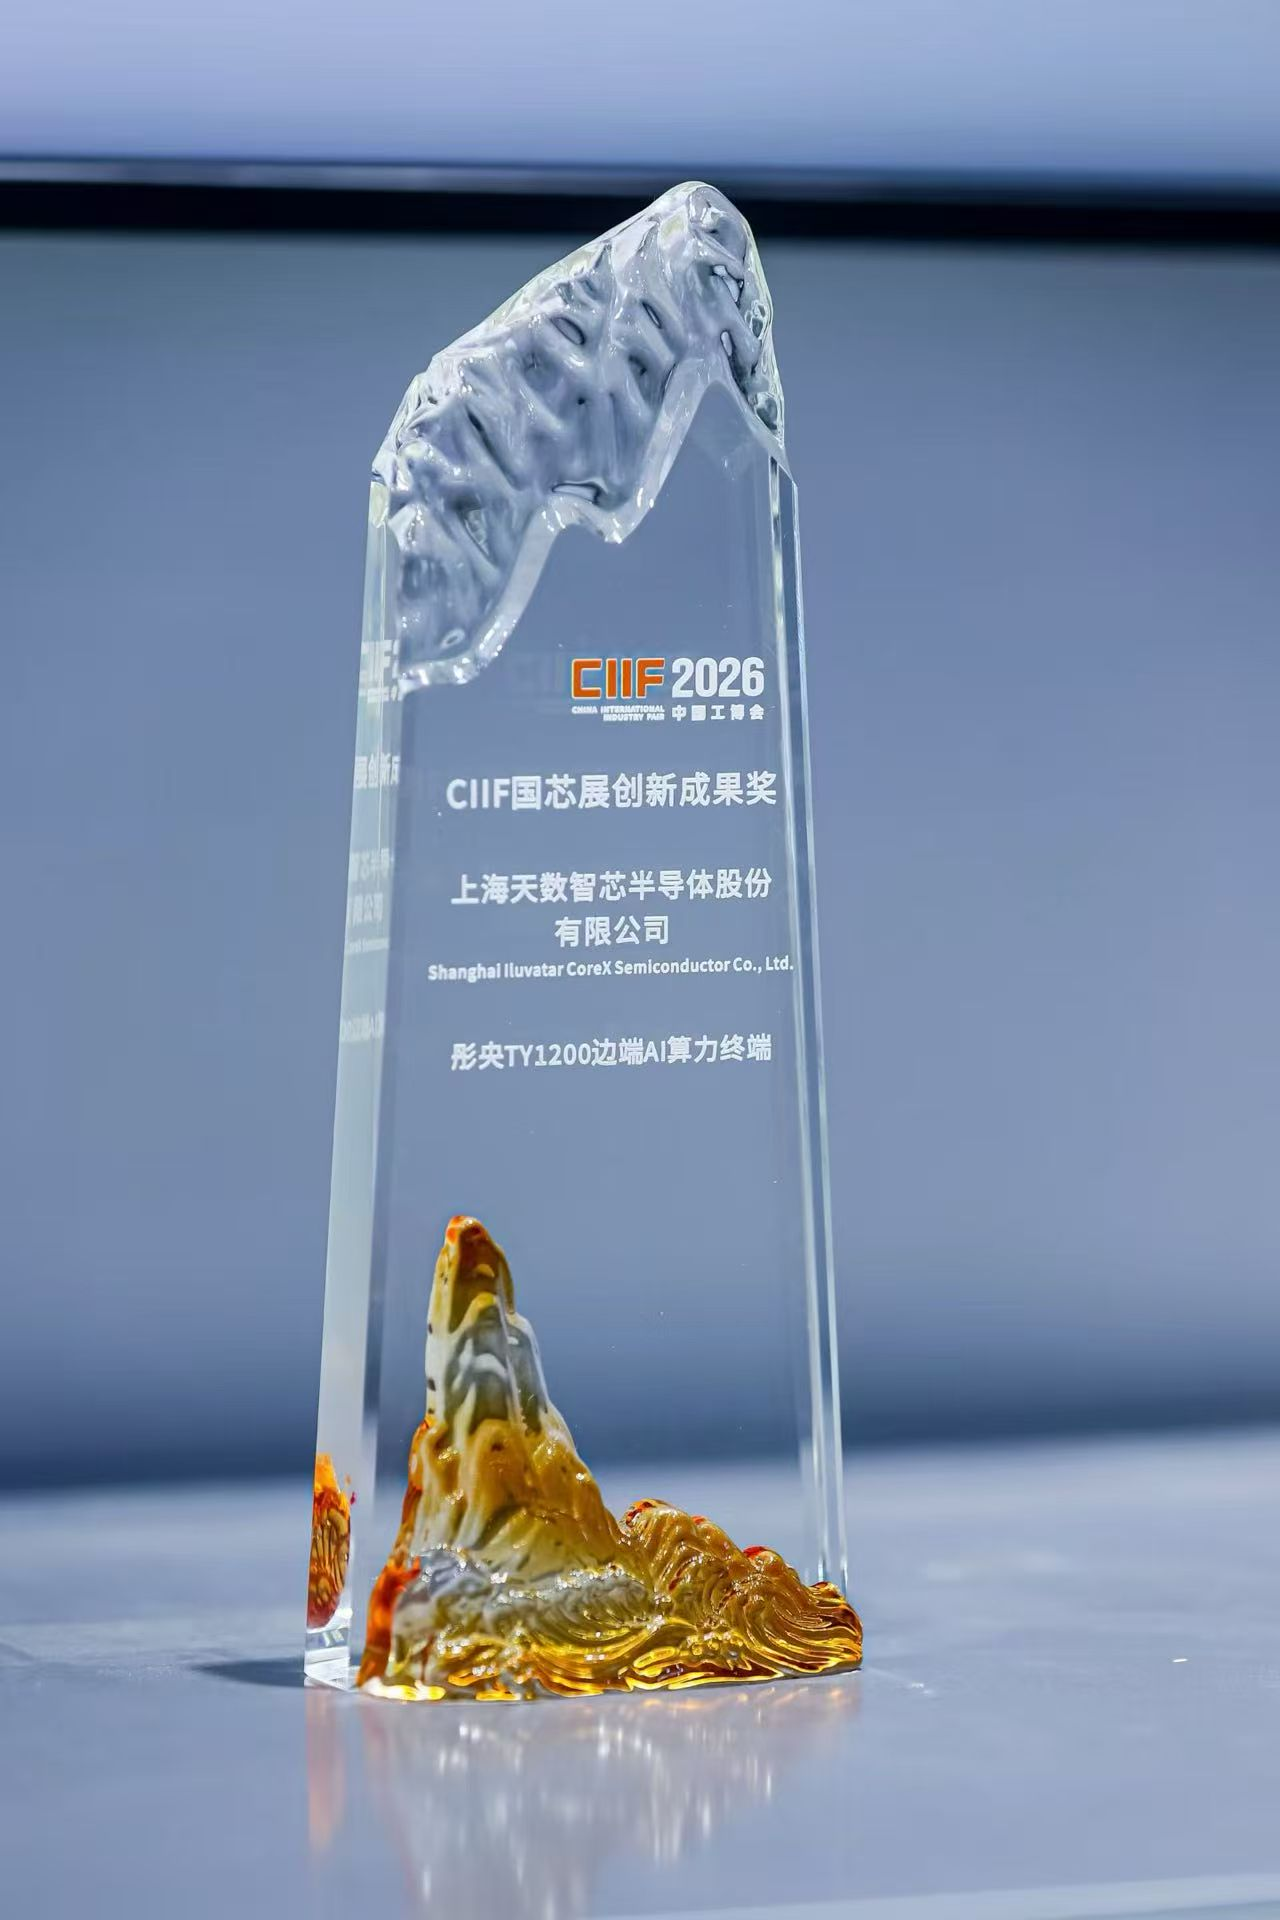
CIIF 2026国芯展创新成果奖奖杯
天垓300 IXL144超节点首次展出
随着大模型参数规模与业务负载持续增长,单台服务器提供的算力逐渐难以满足训练和推理需求,通过高速互联将大量GPU集中到单个机柜内的超节点架构,成为算力产业的重点方向之一。
天垓300 IXL144是天数智芯系统化超节点布局的首个方案:单个机柜可容纳144颗GPU和18颗CPU,显存总量约10.1TB,机柜密度处于业界领先水平,单柜即可承担较大规模的模型任务。产品沿用常规机柜外形规格,无需对机房进行额外改造即可部署,并兼容CUDA生态。
通信方面,该超节点将柜内通信时延控制在100纳秒级,GPU间的数据访问接近本地读取速度,可减少跨机柜通信带来的开销;在特定MoE模型的All-to-All通信测试中,有效带宽提升约15%。据现场测算口径,其每百万有效Token成本较国际主流方案低约40%。
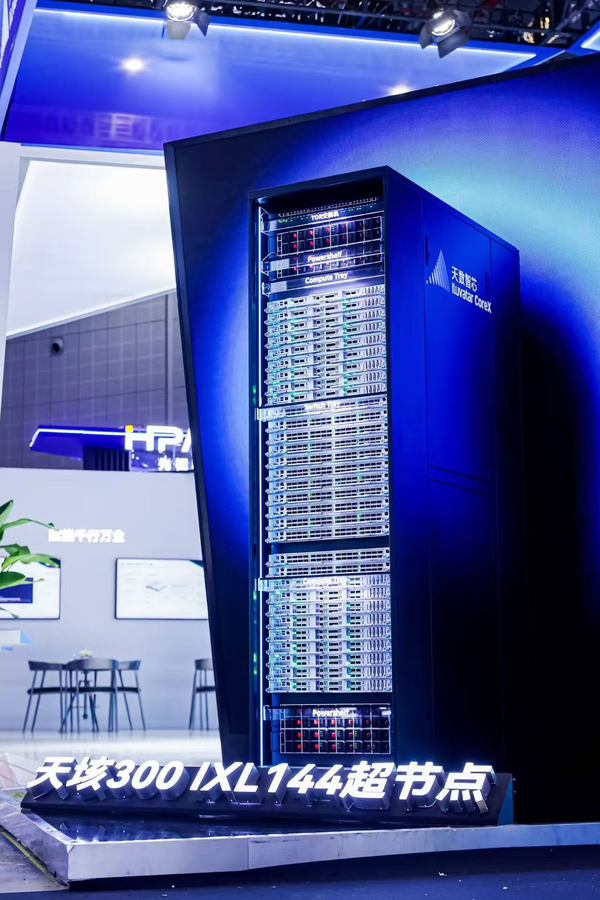
天垓300 IXL144超节点整机柜
天垓300对比测试数据现场展示
在7月的WAIC大会上,天数智芯公布了天垓300与Hopper方案的对比测试结果:在64k长上下文场景中,Attention算子效能高约10%;在DeepSeek V4等MoE模型场景中,计算效率提升超过70%;首字延迟降低约20%,Decode阶段通信延迟降低约13%。
现场展示了上海仪电测试数据,在四大主流模型、三类场景的加权对比中,天垓300折算单卡整体吞吐达到H200的1.05倍,其中Prefill场景达到1.29倍。
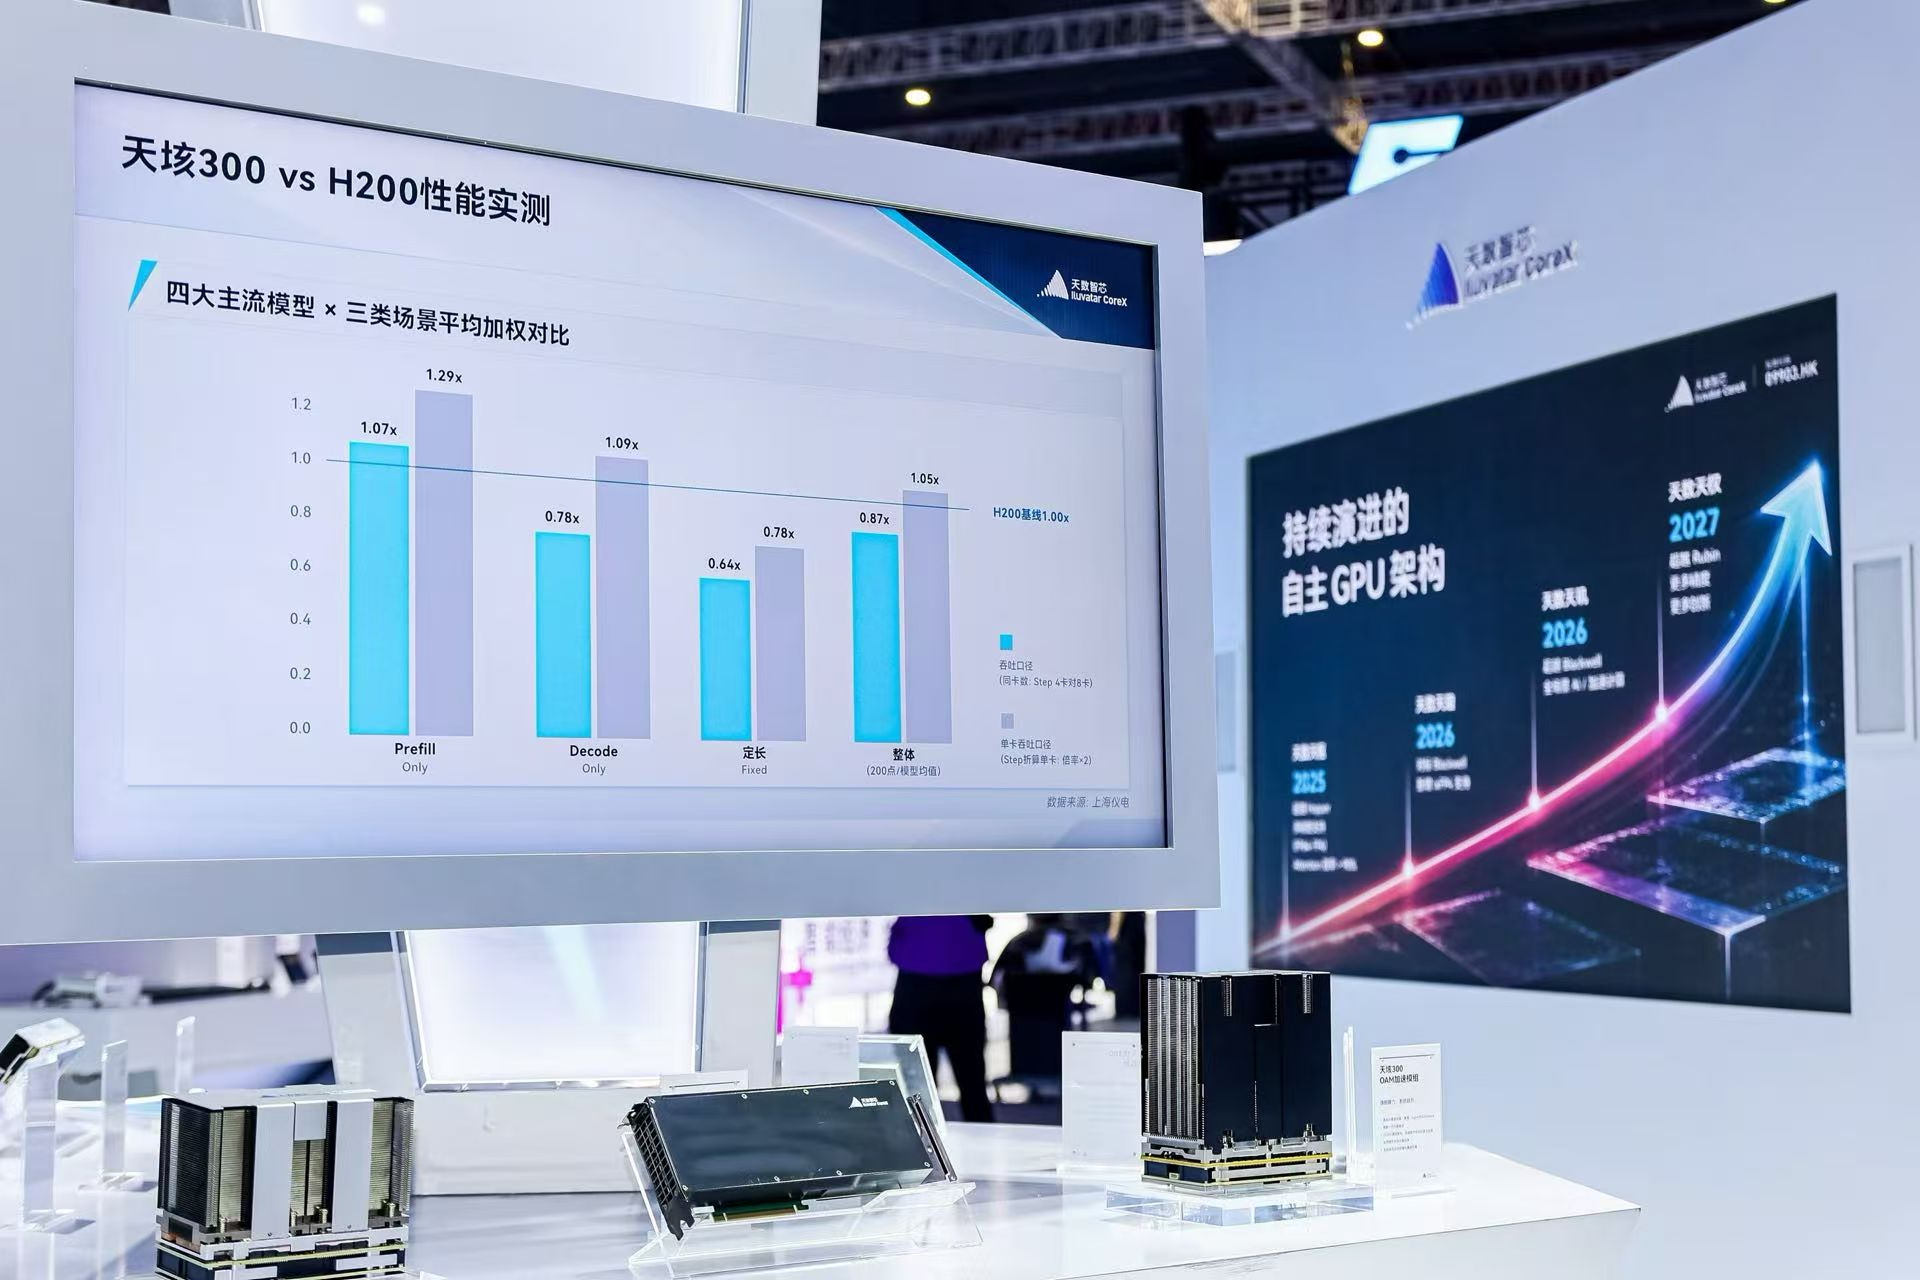
展台大屏展示天垓300与H200对比测试数据
彤央TY1200获国芯展创新成果奖
彤央TY1200是天数智芯推出的边缘AI算力终端,主要面向数据中心之外的端侧、边缘侧推理部署场景。在本届工博会上,该产品获颁CIIF 2026国芯展创新成果奖,反映出其在边缘AI方向的创新得到行业认可。
展会现场,彤央TY1200展示了一类典型应用——作为物理AI载体的“外挂大脑”,为具身智能设备提供模型运行与实时推理能力,提升设备的智能水平。现场演示还涵盖投资材料分析、合同内容审核等数据敏感场景,呈现了同源架构在端侧的模型运行能力:基于本地部署的大模型进行离线处理,通过设定业务规则并结合大模型的理解与泛化能力,相关应用可在彤央TY1200上流畅运行,使端侧AI具备投入实际业务使用的能力。
多行业应用落地进展
在行业应用方面,天数智芯的算力产品已在多个场景落地,涵盖中控技术TPT时序大模型、银联云算力服务、GeoEast处理系统千卡级部署,以及卫宁健康WiNGPT医疗大模型等。
目前,其产品已进入30多个行业,服务客户380余家,累计落地项目超过1000个,并完成万卡级规模部署。从本次展出的产品来看,算力产品线已覆盖数据中心训练、推理和边缘侧部署三类场景。
总体来看,从天垓300 IXL144超节点首次公开亮相、天垓300对比测试数据现场公布,到彤央TY1200获得国芯展创新成果奖,天数智芯在本届国芯展上集中展示了新产品、实测数据与多行业落地进展,覆盖数据中心到边缘侧的算力产品布局清晰呈现。未来,天数智芯将继续推进“通用GPU+自研软件栈”体系建设,与上下游生态伙伴协作,推动高质量算力从单卡走向整柜、从云端延伸至端侧,服务更多产业场景。
2. 全球首款搭载脑机接口的AI眼镜,Looktech新品发布
在近日举办的2026法国巴黎国际光学眼镜展上(SILMO),Looktech正式发布新一代AI智能眼镜,也是全球首款搭载脑机接口的AI眼镜。该产品集成多项健康传感器,进一步丰富感知能力;搭载物奇微智能音频主控方案,提供出色的AI交互与无线连接性能;同时采用碳纤维工艺与醋酸纤维材质,兼顾全天候舒适佩戴体验与时尚外观。
新增脑机接口和多维度健康传感器,进一步丰富AI眼镜感知能力
Looktech是国内知名脑机接口公司回车科技旗下品牌,此次发布的新一代AI智能眼镜,将公司的核心技术带到了AI眼镜品类。该产品内置EEG脑电传感器,可采集脑电信号,获取用户情绪、大脑健康等生理状态信息,让AI除了可以“感知世界” ,也能 “理解佩戴者本身”。
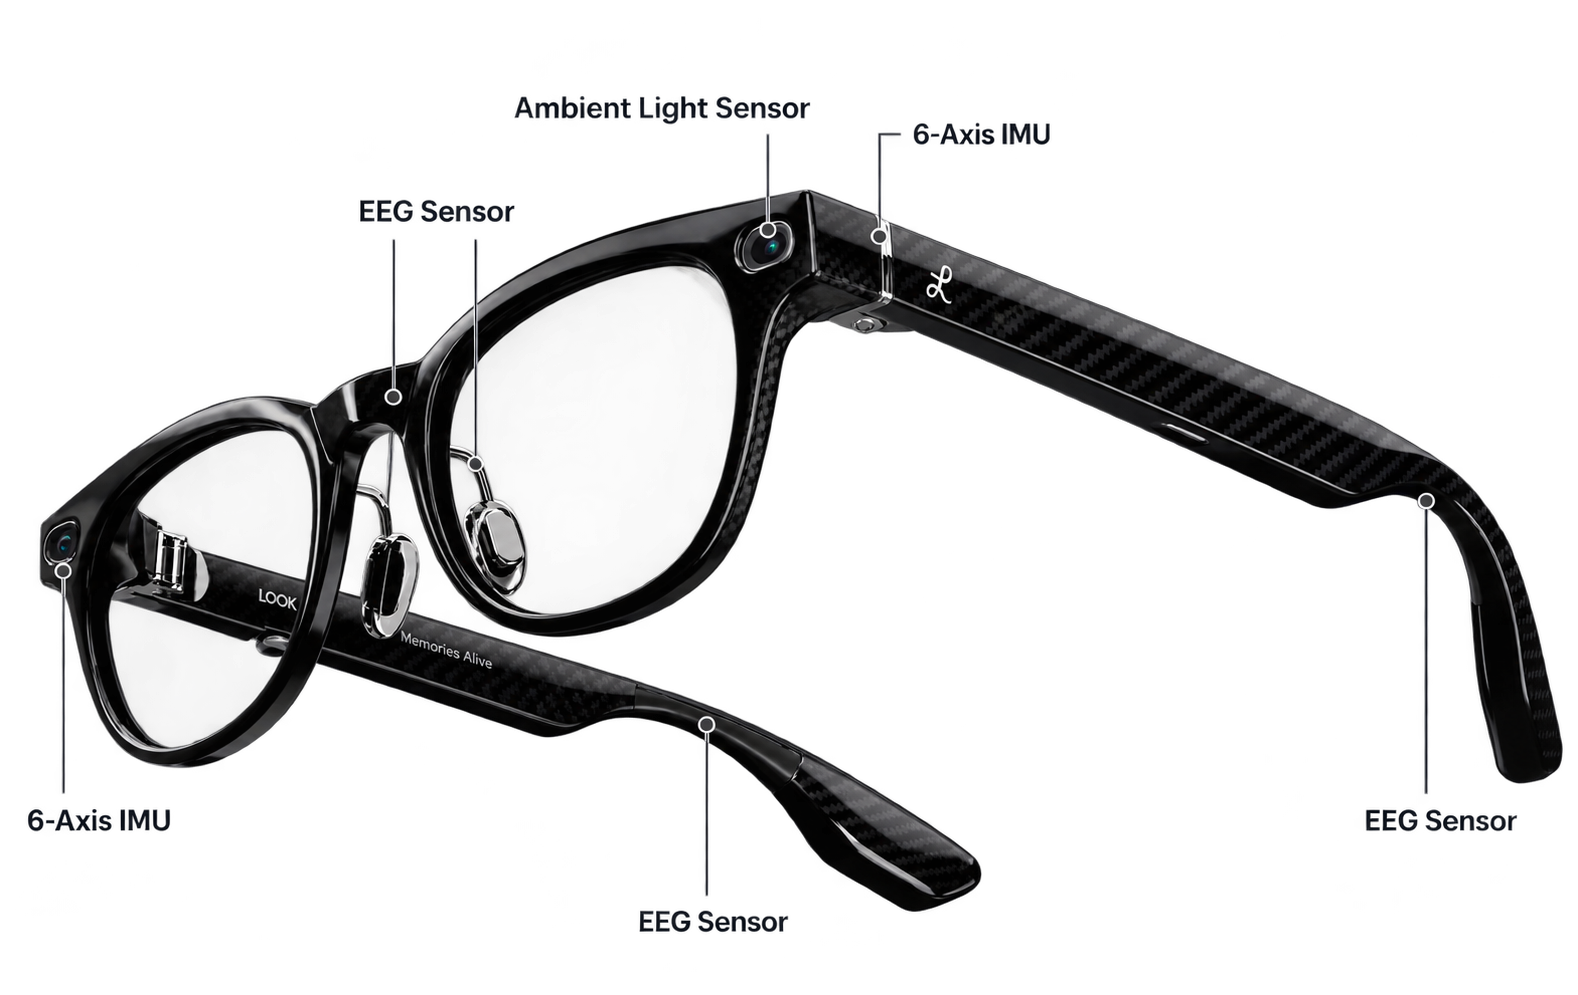
除了脑机接口,Looktech新一代AI智能眼镜还进一步强化了多维度健康感知能力。通过搭载六轴IMU、环境光传感器等多组健康感知器件,依托眼镜全天候佩戴的优势,持续监测颈部姿态、户外光照时长以及眼健康相关数据,积累长期健康数据,为用户提供持续性的健康参考,构建起环境与人相结合的全方位感知体系。
搭载物奇微智能音频主控芯片,赋能产品语音交互、无线连接与大模型协同能力
Looktech首款AI智能眼镜搭载WUQI物奇微WQ7036AX高性能智能穿戴SoC,负责眼镜的语音处理和基础连接。此次发布的新一代产品,同样采用了物奇微WQ7036系列智能音频主控。该方案集成VAD和KWS算法方案,显著提高复杂语音态下的唤醒率;拥有完整的通话降噪和音效算法方案,能够为AI眼镜带来绝佳的畅听体验;通过稳定的蓝牙连接和低功耗控制与交互,为大语言模型AI助手实现智能识图和多语言实时翻译提供稳定保障。
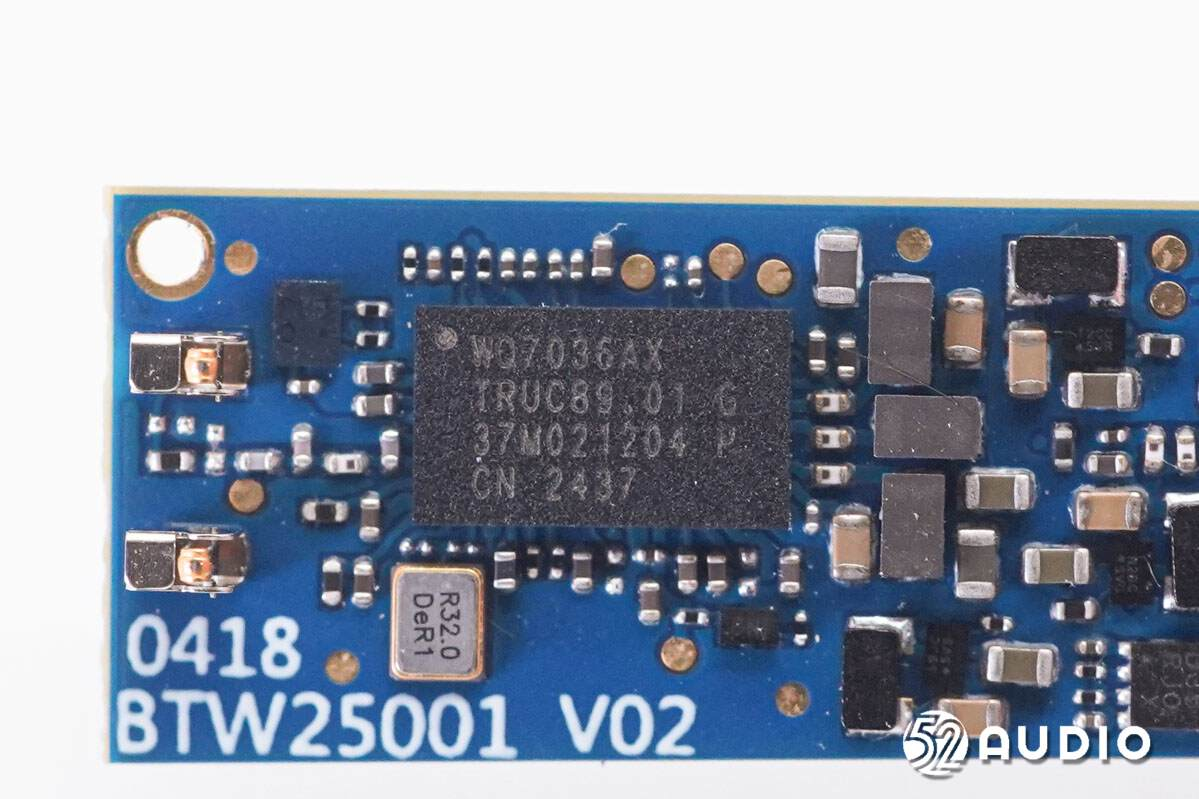
Looktech AI智能眼镜搭载的物奇微WQ7036AX主控芯片
作为已在AI眼镜领域规模化落地的成熟国产方案,物奇微智能音频主控凭借高集成度架构、领先的低功耗设计、稳定的蓝牙连接性能和完整的音频算法矩阵,完美适配新品狭小的机身空间与全场景功能需求。目前,物奇微智能音频主控芯片已应用于影目、极米、NIMO、加南、Looktech、LOHO、VITURE等超过10个品牌的AI眼镜产品,涵盖AI音频眼镜/AI拍照眼镜/AR眼镜等多个中高端品类。
采用碳纤维工艺和醋酸纤维材质,实现轻量化和多元化外观
在外观方面,Looktech攻克了碳纤维在AI智能眼镜上的应用工艺,利用碳纤维高强度、轻量化的材料特性,进一步减少结构占用空间,实现更轻、更薄的产品形态。
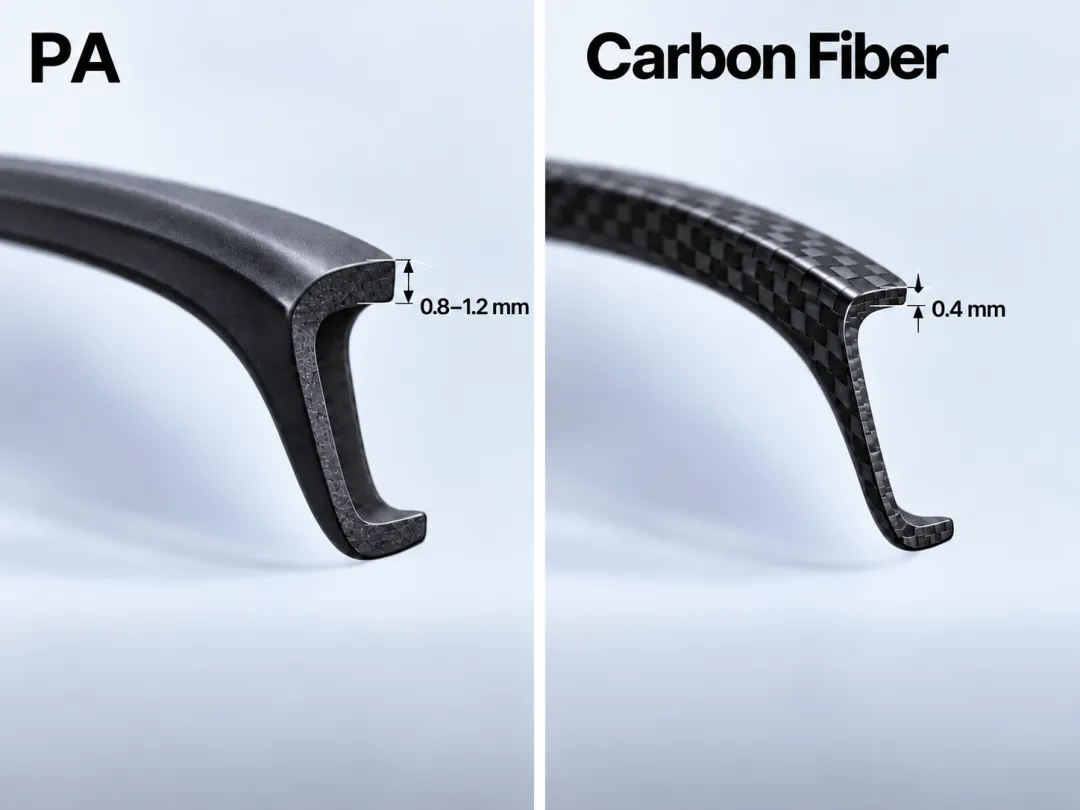
Looktech新一代AI智能眼镜镜腿壁厚低至0.4mm,镜腿相比上一代产品缩窄约25%,整机重量控制在30克以内,整体外观进一步接近传统眼镜。配合电子器件与内部结构的小型化,为用户提供更持久舒适的佩戴体验,为全天候智能陪伴奠定基础。
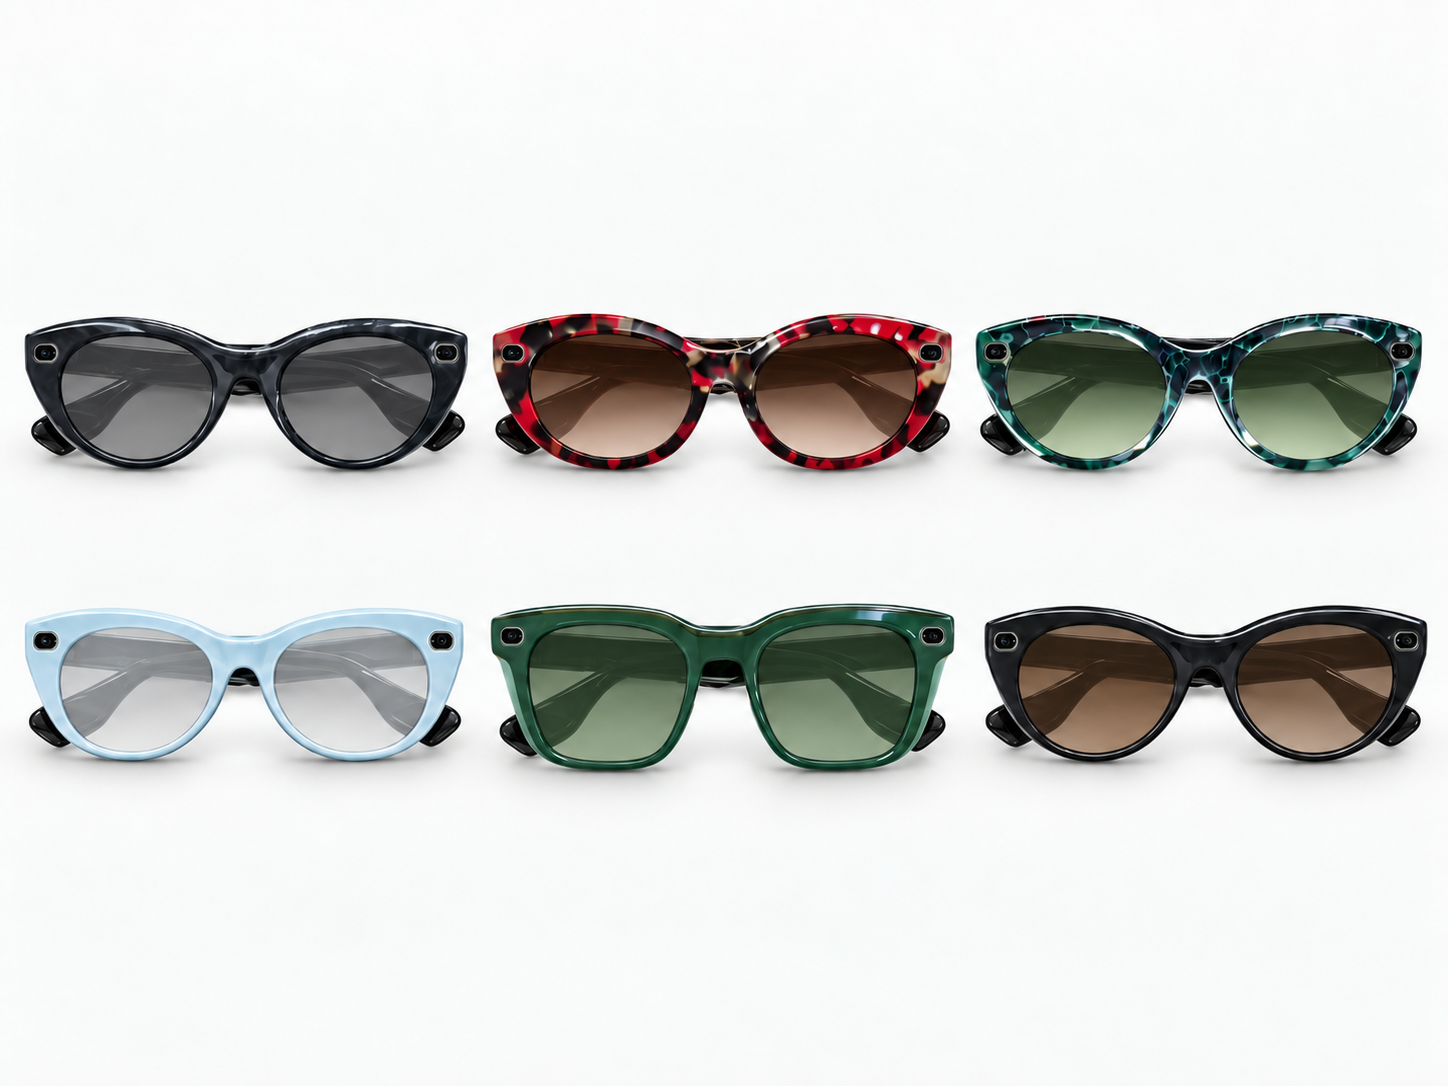
Looktech还实现了醋酸纤维与智能电子结构融合,打破AI眼镜外壳只能采用注塑件的局限。醋酸纤维拥有丰富的颜色、纹理和质感,是传统中高端眼镜中非常重要的材料。Looktech新一代AI智能眼镜依托这一工艺优势,将科技性能与时尚设计相结合,摆脱了智能眼镜外观样式单一的行业困境。
随着AI智能眼镜的发展,语音交互、AI大模型、摄像头、显示屏等功能相继落地,不断丰富产品的功能和使用场景。此次Looktech发布的新一代AI智能眼镜,通过搭载EEG脑电传感器等配置,进一步拓展了产品感知能力,让AI能够更主动、深入的了解用户状态和需求。与此同时,产品通过轻量化设计和时尚外观,让用户真正愿意长时间佩戴AI智能眼镜。
3. AI缺货潮还有2至3年 内存恐率先降温?陈立武示警
英特尔(Intel)首席执行官陈立武(Lip-Bu Tan)表示,人工智能(AI)基础设施建设持续扩张,预计AI硬件供应短缺将延续两至三年,但内存市场可能是最早降温的领域之一。他并警告,AI产业除了面临资金瓶颈,长期仍须证明投资回报率(ROI),才能维持投资者信心。
Wccftech、CNBC等外媒报道,陈立武12日在新加坡星展银行(DBS)举办的活动中指出,AI计算需求快速增长,供应链持续面临产能限制,短期内难以全面缓解。
目前内存芯片供不应求,已连续数月推升价格,台积电先进封装产能也持续吃紧,反映AI基础设施扩张对半导体供应链造成的压力。
不过,陈立武认为,即使整体AI硬件短缺仍将持续,内存市场也可能率先失去部分增长动能。
值得注意的是,陈立武并未进一步说明内存可能降温的具体时间或原因,也未预测价格将反转下跌,因此仍不能将其说法直接解读为内存即将进入跌价周期。
陈立武并强调,资金是AI建设的主要限制之一,产业最终必须展现实际投资回报,才能让庞大的资本支出与增长预期持续获得市场支持。
另一方面,网络通信芯片大厂博通(Broadcom Inc.)首席执行官陈福阳(Hock Tan)12日则在同一场合表示,过去两年来,AI产业一再面临供应瓶颈,但随着产能持续扩充,预计部分限制将逐渐缓解。“过去两年,我们看到一连串供应瓶颈接连浮现,但最终都一一克服。今天的内存短缺问题,一年后可能就不再存在。”
他认为,晶圆供应短缺的情况可能在2028年或2029年获得缓解,而随着新的基础设施陆续启用,电力供应也可能改善。(来源: moneydj)
4. 应材50亿美元 EPIC 中心揭幕 魏哲家:加速2纳米之后技术走向量产
应用材料公司斥资50亿美元打造的硅谷EPIC中心正式揭幕,台积电、英特尔、三星、美光及SK海力士共同担任创始合作伙伴,将工程团队与技术开发需求带进同一座研发基地,加快新材料、设备与制程从研发走向量产。台积电董事长暨总裁魏哲家表示,面向2纳米之后的技术世代,与应材合作将有助提早取得突破性设备技术,推进新架构、低电阻布线及先进封装。
EPIC为设备与制程创新暨商业化中心,位于应材加州桑尼维尔园区,占地60万平方英尺,设有近4英亩先进无尘室。应材表示,这是全球规模最大的半导体制造技术与制造设备协同研发基地,目标是将过去分散进行的材料研究、设备开发及制程整合集中协作,缩短技术导入晶圆厂的时间。
应材总裁暨执行长盖瑞.迪克森(Gary Dickerson)表示,AI基础设施扩张与高效能运算需求,正将芯片制造技术推向前所未有的复杂度。产业必须重新思考合作模式,让芯片制造商、系统设计厂商、设备伙伴与研究人员共同投入,才能加速材料创新,更快实现高量产制造。
应材半导体产品事业群总裁帕布.若杰(Prabu Raja)指出,在原子尺度下,材料及材料界面会呈现不同特性,开发方式已难以沿用传统线性模式。透过客户工程团队在技术导入自家晶圆厂前就参与优化,可提高研发成功率,更早达到高效能与高良率。
魏哲家表示,台积电与应材合作三十年,最先进量产制程从350纳米推进至2纳米,特征尺寸缩小175倍。随芯片制造复杂度呈指数成长,双方合作比以往更加重要;透过EPIC,将共同加速从数据中心到边缘运算的AI创新,推动更高能源效率的AI架构。
英特尔执行长陈立武表示,AI正创造数万亿美元商机,产业须持续推动晶体管、互连布线及先进封装创新。英特尔认为,到2030年单一封装内的晶体管数量将突破1万亿个,随架构复杂度及研发成本上升,与设备伙伴紧密合作,有助提升研发效率并加快新技术上市。
存储芯片厂商也将透过EPIC加快技术开发。美光董事长暨执行长Sanjay Mehrotra表示,资料密集型AI工作负载大幅推升高效能存储芯片与储存需求,材料与制程创新是下一代存储芯片发展的关键,美光将与应材共同推动技术从研究走向规模化量产。
SK海力士总裁暨执行长郭鲁正指出,AI运算的核心挑战,是数据传输速度能否跟上处理器效能提升,必须仰赖更高带宽、更快速度及更大容量的存储芯片。双方将结合先进存储芯片与材料工程能力,因应HBM、DRAM及NAND的重大技术转折。
三星电子装置解决方案事业部技术长宋在赫表示,三星的AI布局涵盖先进逻辑、存储芯片与先进封装,应材在三大领域均具备广泛制程设备技术,透过EPIC可加速共同开发、优化及导入突破性技术。
先进封装也是合作重点。博通半导体解决方案事业群总裁Charlie Kawwas表示,AI下一波发展取决于运算、存储芯片与连接技术能否整合为高效能系统,背后需要先进封装突破。提早参与应材技术与制造能力开发,可让未来系统需求与封装创新更紧密结合。
贝思半导体总裁暨执行长Richard Blickman则指出,混合键合是新一代AI系统的关键基础技术。贝思的高精度裸晶对晶圆键合能力,结合应材前段制程技术,将共同推进高效能3D整合元件,EPIC也将把这种协同开发模式扩展至更多伙伴。
爱德万测试集团执行长Doug Lefever表示,先进3D架构与异质整合发展,使前段制程与后段测试、量测信息的串联更加重要。双方将结合材料工程、制程控制及测试能力,协助客户提升良率、加速量产导入。
SCREEN集团总裁暨执行长后藤正人表示,将在EPIC协同优化关键湿式与干式制程,因应更复杂的3D元件及先进封装结构;铠侠技术长宫岛秀史则表示,未来技术突破有赖存储芯片、逻辑及互连在整合系统中紧密协作,透过跨领域工程团队合作,可加快下一代存储芯片开发。(来源: 经济日报)
5. 英特尔、博通齐发警告:资本或成AI扩张最大瓶颈
人工智能(AI)基础设施建设热潮持续,但英特尔与博通两家半导体巨头的高管近日发出警告:随着行业加速建设算力基础设施,融资能力和资金成本可能成为制约AI扩张的重要因素,其影响甚至可能超过芯片、存储器或电力短缺。
博通首席执行官陈福阳(Hock Tan)10月12日在新加坡举行的星展亚洲未来前瞻会议上表示,随着业界竞相建设支持复杂AI模型运行的基础设施,资本可能成为行业扩张面临的最大约束。“我认为最大的约束可能是资本。”他指出,AI算力基础设施需求仍持续超过供应,但资金获取能力可能影响后续建设速度。
英特尔首席执行官陈立武(Lip-Bu Tan)也表达了类似担忧。他指出,当前挑战之一是资本及其成本不断上升;从长远来看,市场还将关注大规模投资AI的企业能否获得足够的投资回报。
两位高管的表态显示,AI基础设施建设面临的挑战正从芯片、存储器和电力等供应问题,进一步延伸至融资能力与投资回报。随着相关投资规模不断扩大,资金成本和回报预期可能成为影响行业持续扩张的重要因素。
6. 明年百万颗!微软2nm AI芯片官宣:每瓦算力自称比GPU高40%
微软发布第三代自研AI芯片Maia 300,明年部署量或超百万颗,并以吉瓦级规模成为其AI推理主力。该芯片采用Chiplet架构与台积电2纳米制程,单位电力Token产出较主流GPU高约40%。云厂商自研芯片浪潮下,微软正加速降低对英伟达的依赖,但其模型训练仍将依赖英伟达与AMD。
 百万颗与吉瓦级:一场“降本”驱动的算力搬家
微软周一(10月12日)发布第三代自研AI芯片Maia 300,计划明年部署可能超过100万颗,支撑内部AI服务,并通过提升整体系统效率降低运算成本。据《路透》报导,Maia 300主要用于处理AI运算,包括编程设计,以及代替使用者执行复杂的商业任务;其前一代产品已用于运行微软自家AI模型,以及通过Azure云端服务提供的OpenAI模型。微软同时宣布,自2027年起,Maia系列将成为其AI产品的主要算力系统,部署规模以吉瓦计。
大规模部署的底气来自成本账。微软此前向投资者披露,上一代Maia 200芯片在运行OpenAI及微软自有模型时,运营成本较英伟达尖端芯片低30%至40%;同等价格下,其性能较同类产品高出30%。微软Azure Maia总经理Andrew Wall则向《巴伦周刊》表示,持续投资客制化芯片是长期AI基础建设策略的一环,“报导中的数字并未反映我们整体计划的规模”,Azure Maia的部署将支撑以GW计算的AI工作负载需求。投行Evercore ISI预估,到2027年第一季度,Maia芯片将占到微软AI芯片采购开支的10%。
背景是惊人的投入规模:微软今年资本支出预计超过1750亿美元。在AI基础设施持续扩建的同时,如何提高每笔投入的运算效益,已成为云厂商的必答题。微软数据中心硬件业务负责人Rani Borkar的表述相当直白:透过整体系统优化,公司希望让每一瓦电力、每一美元投入,以及每一字节存储芯片,都能支撑更多AI运算。“我们有信心,已经为这些工作负载打造出了最好的产品。基于这一信心,我们将从明年开始以吉瓦级规模部署Maia。”
Chiplet路线:用2纳米小芯片对抗英伟达的“大芯片”
Maia 300与英伟达产品走的是两条不同的技术路线。英伟达的AI加速器采用大型运算芯片,周围搭配高带宽存储芯片;Maia 300的核心运算处理器则采用Chiplet(小芯片)设计,将多颗通常各有专门功能的芯片整合在一起。其中,负责关键运算功能的小芯片采用台积电2纳米(N2P)制程,负责将资料移出处理器、传送至系统其他部分的小芯片,则使用成本较低的3纳米制程。据公开资料,Maia 300配备288GB HBM4内存,带宽达18TB/s,FP4算力可达13.8 PFLOPS;其架构以推理优先设计,针对长上下文、内存密集及智能体任务等负载进行优化。
机柜层面的对比更直观:Maia 300将配置于每座搭载96颗芯片的服务器机柜,功耗约167千瓦;相较之下,英伟达最新GB300 AI服务器机柜搭载72颗GPU,功耗约142千瓦。微软表示,Maia 300每消耗1百万瓦电力所能完成的有效运算量,比“领先的GPU系统”高出约40%;单机柜Token吞吐量最高可达上一代的7倍。不过,微软并未揭露比较所采用的具体系统,这组数据不能直接视为与GB300的对比结果。
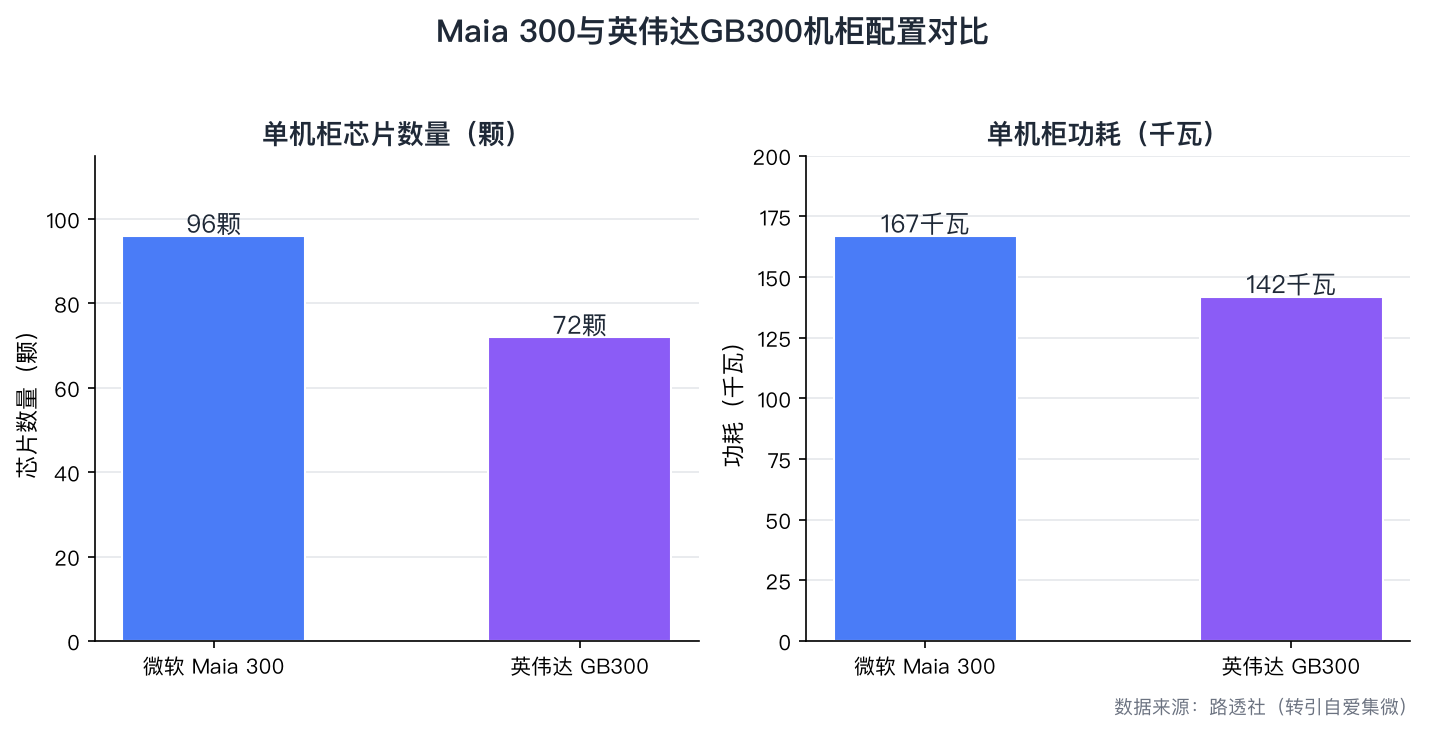
【图表:Maia 300与英伟达GB300机柜配置对比】
图表解读:Maia 300单机柜芯片数量更多、功耗也更高,以更密集的芯片配置换取机柜级吞吐;微软的卖点不在这组绝对值,而在于每瓦电力产出的Token更多。
从Maia 100(2023年11月推出,5纳米工艺、1050亿颗晶体管)到Maia 200(2026年1月推出),再到如今的Maia 300,微软自研芯片的部署规模正在数量级跃升:据《The Information》此前报导,微软与台积电洽谈2027年交付逾30万颗的产能合同,相较Maia 200仅数万枚的产量是一次数量级的跃升;而本次公布的明年部署计划超过100万颗。
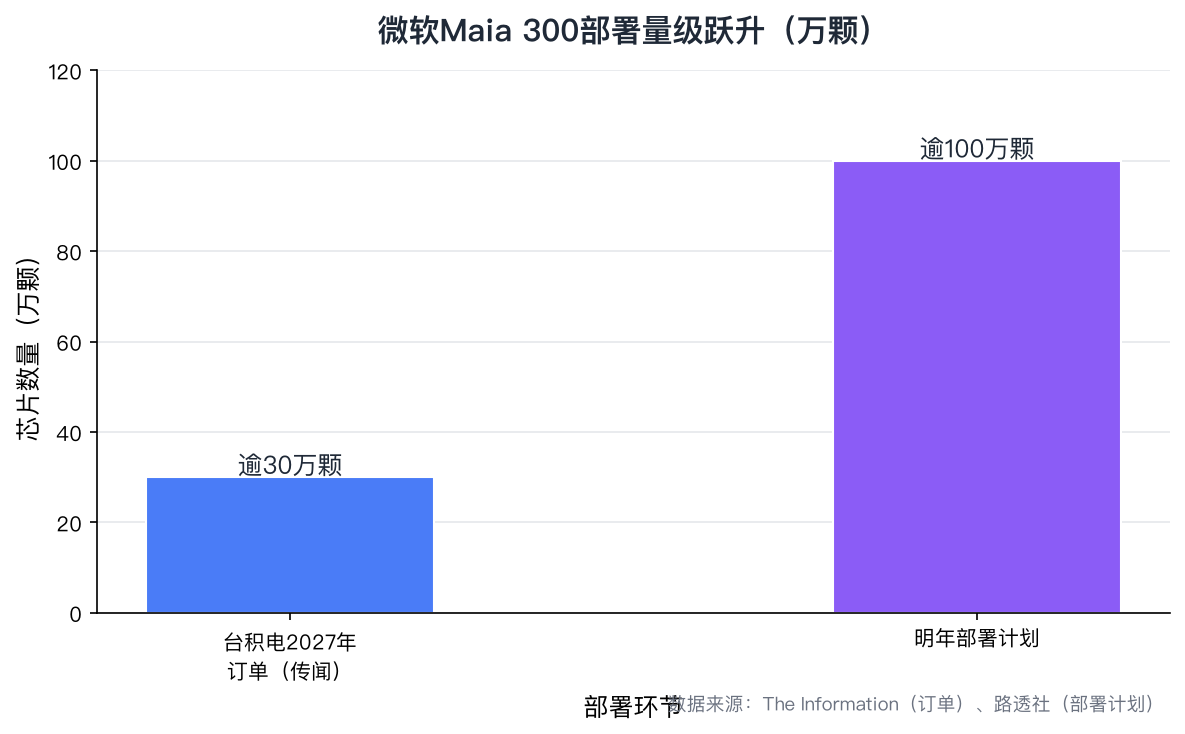
【图表:微软Maia 300部署量级跃升】
图表解读:从台积电2027年逾30万颗订单传闻,到明年逾100万颗的部署计划,微软自研芯片正在从“小规模验证”走向“主力承载”。
自研棋局:微软为何落后,又为何必须追
在云厂商自研芯片这场竞赛中,微软并不占先。谷歌TPU和亚马逊Trainium已赢得多家大客户采用,谷歌甚至开始向外部客户销售TPU;亚马逊最新款Trainium3已于2025年12月发布。而Maia 200的使用者此前仅有微软自身,且截至9月底仍只在美国中国两座数据中心运行。正因如此,微软正积极与Anthropic等大型云客户就使用Maia芯片展开谈判。不过与谷歌、亚马逊不同,微软这款加速芯片暂不对外按小时出租;行业咨询机构Moor Insights首席执行官帕特里克·穆尔黑德直言,除微软内部之外,尚无外部企业对该芯片开展过测试。
自研浪潮的产业外溢已经显现。作为云厂商与AI厂商自研芯片的主要生产方,ASIC厂商正持续受益:博通2025年第二季度AI业务收入52亿美元,同比增长63%,公司并预计第三季度将进一步增至62亿美元,同时在财报期宣布拿下第四个量产客户的100亿美元订单,预计2026年开始交付;Marvell在亚马逊Trainium2等需求带动下,同期数据中心业务收入14.9亿美元,同比增长69%。IDC计算系统平台与技术研究总监Jim Hines指出,微软发展自有芯片设计能力,反映出超大规模云端服务商正出现更广泛的垂直整合趋势——面对成本上升、电力限制及供应受限,厂商正逐步整合AI基础建设的整个技术堆叠。
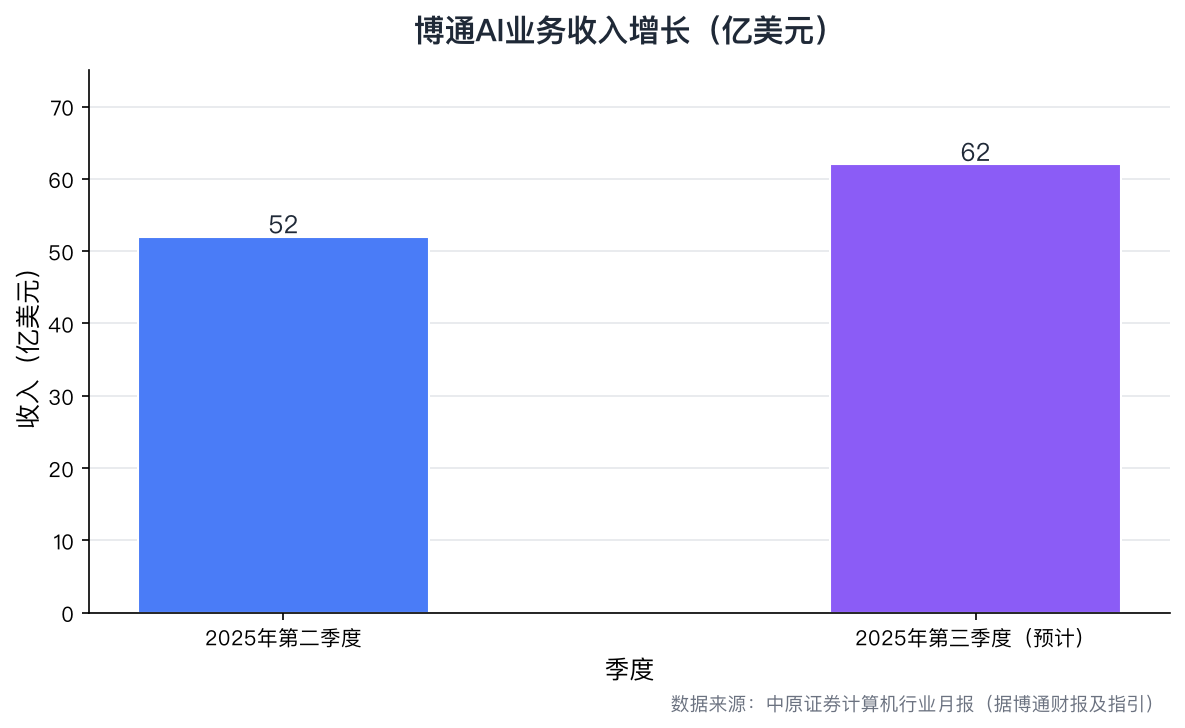
【图表:博通AI业务收入增长】
图表解读:作为谷歌TPU、Meta等定制芯片的代工设计方,博通AI业务收入从52亿美元增至预计62亿美元,是云厂商自研浪潮最直接的产业注脚;微软Maia虽未采用博通量产方案,但同一逻辑正在更多巨头身上复制。
值得注意的是,自研并不意味着替代。微软CEO纳德拉强调,公司与英伟达、AMD之间保持着“伟大的合作伙伴关系”,具备垂直整合能力并不意味着只使用自家技术而放弃生态合作伙伴的解决方案,微软仍将依赖来自英伟达、AMD等供应商的多元化硬件组合。在模型训练业务上,微软仍会和英伟达、AMD展开合作;Maia芯片目前也优先用于Copilot等内部AI服务,而非向外部客户出租算力。
未来展望:吉瓦级野心与10%的第一个刻度
按微软披露的路线,其自研芯片的迭代已经排至2028年:Maia 280计划2027年发布,由两颗芯片连接组成,性能功耗有望比英伟达同年产品高出30%;Maia 400计划2028年量产;最终目标是年产数十万颗自研AI芯片。若Maia 300如期在明年实现百万颗级部署,Evercore ISI预测的“2027年一季度占AI芯片采购开支10%”,将只是这条路线上的第一个刻度。
对英伟达而言,短期冲击有限——云厂商自研芯片瞄准的是内部推理负载这一最具成本弹性的环节,模型训练与外部算力生态仍高度依赖GPU;但长期看,当吉瓦级的推理需求逐步转向自研芯片,AI算力市场的成本结构与议价逻辑都将被改写。正如行业点评所言:随着AI推理需求持续增长,云厂商正通过自研芯片提高能效、控制成本,若Maia 300达到预期表现,微软有望降低对英伟达GPU的依赖,并改善AI服务的运营经济性。这场从“买算力”到“造算力”的搬家,才刚刚开始。