1. 物联芯片主力军:紫光展锐以全栈能力驱动万物智联规模应用
2. 自研芯片围攻之下,GPU的护城河还剩多深?
3. DeepSeek开源“推理发动机”DeepInfer:155万亿Token/天的吞吐秘密(兼容英伟达SM100与华为昇腾950,推理降本从“模型”走向“系统工程”)
4. 工业和信息化部:推动人工智能深度赋能新型工业化
5. 重仅1克 我国科学家研制世界最轻无线介观显微镜
1. 物联芯片主力军:紫光展锐以全栈能力驱动万物智联规模应用
随着蜂窝物联网进入规模化落地与价值升级并行的新阶段,全球产业正加速从“万物互联”迈向“万物智联”。
公开数据显示,2025年全球蜂窝物联网连接规模达到47亿,预计2026年增长至54亿,复合年增长率14.3%。5G RedCap等新技术的兴起,进一步打开工业、能源、物流等垂直行业的增量空间。
在这一产业浪潮之下,物联网通信芯片作为底层底座,其技术实力、产品完备度、全球化服务能力,直接决定了行业智能化应用落地规模。作为全球领先的平台型芯片设计企业,紫光展锐已经成长为全场景物联芯片主力军,在技术、产品、海外市场、行业落地层面交出了可观的产业答卷。
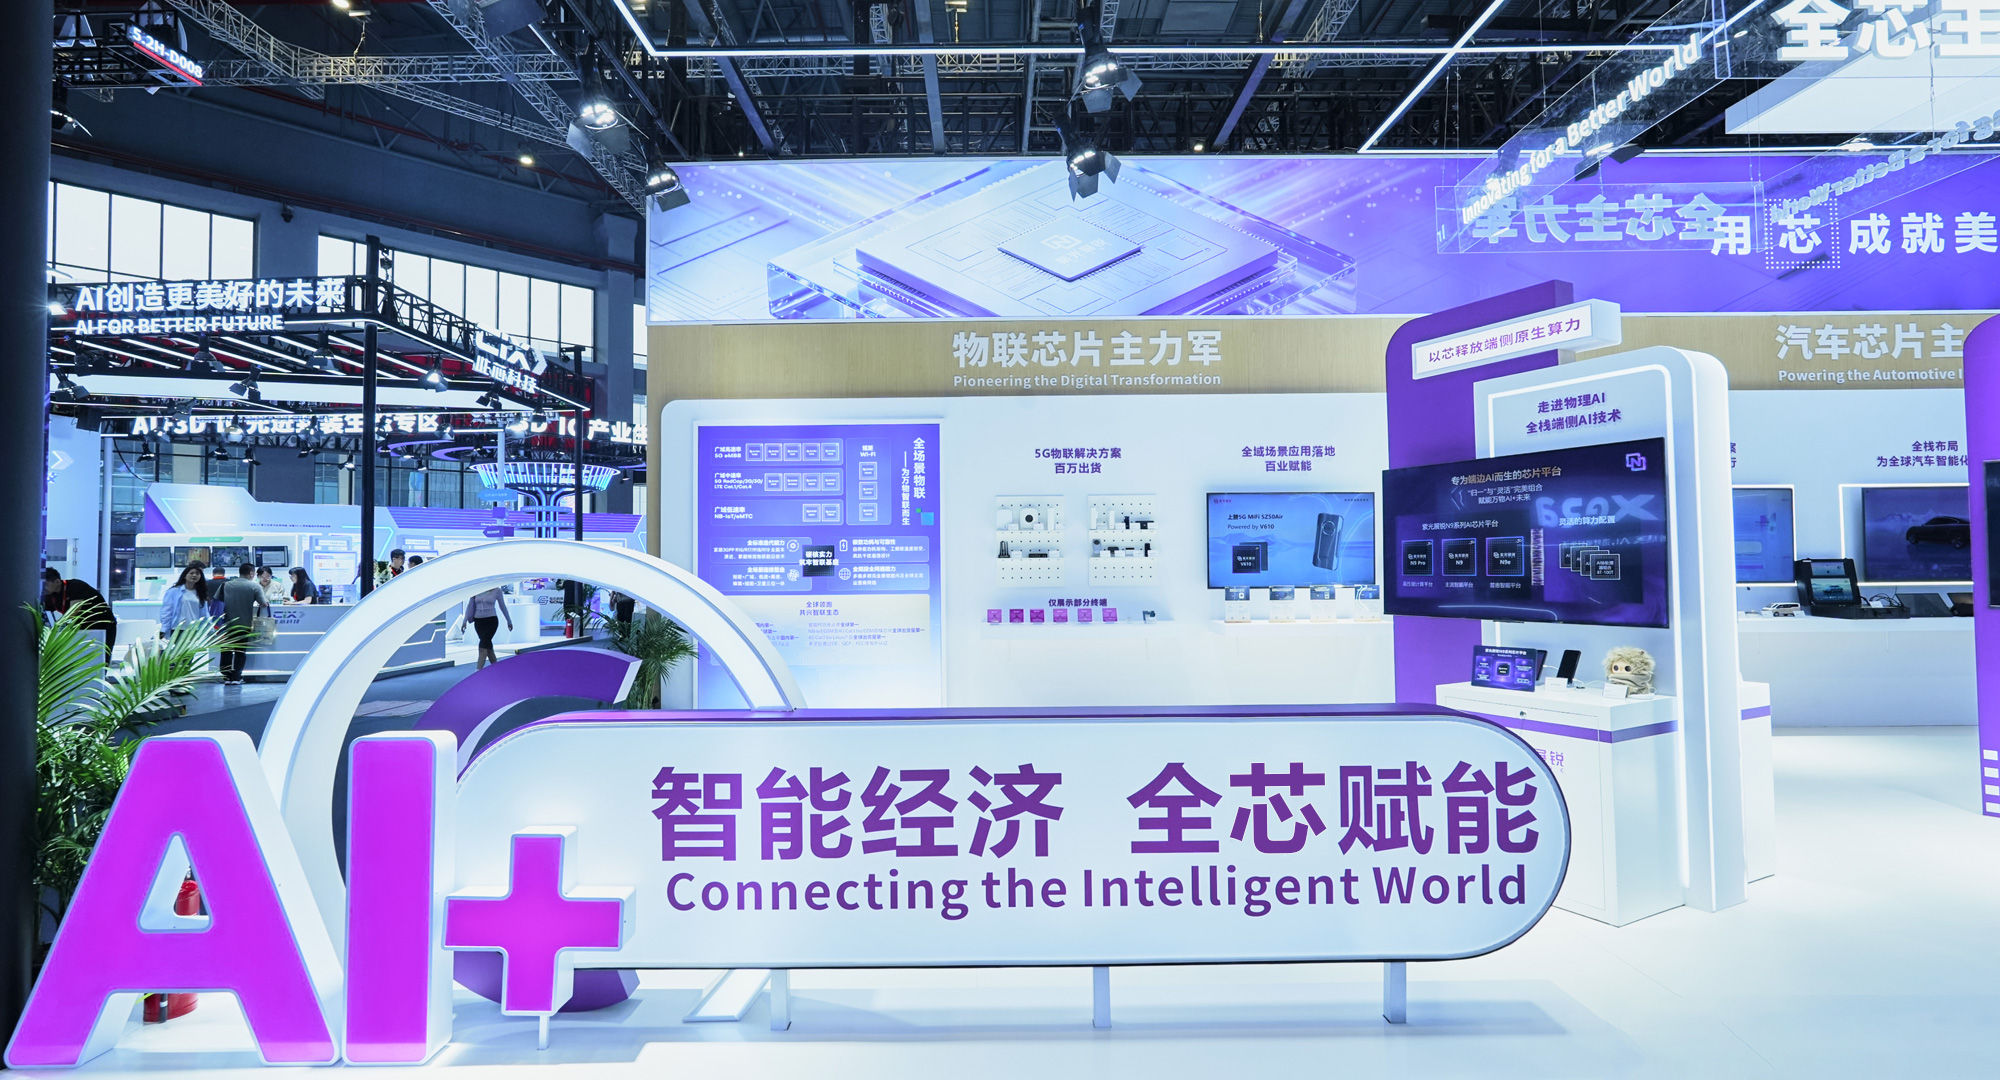
深耕底层技术,构筑四大核心技术壁垒
物联网芯片的竞争,最终是底层技术体系的比拼,单点性能突破难以支撑千行百业复杂的现实需求。依托二十多年通信与计算能力积累,紫光展锐沉淀出四大核心能力,构成物联业务的护城河。
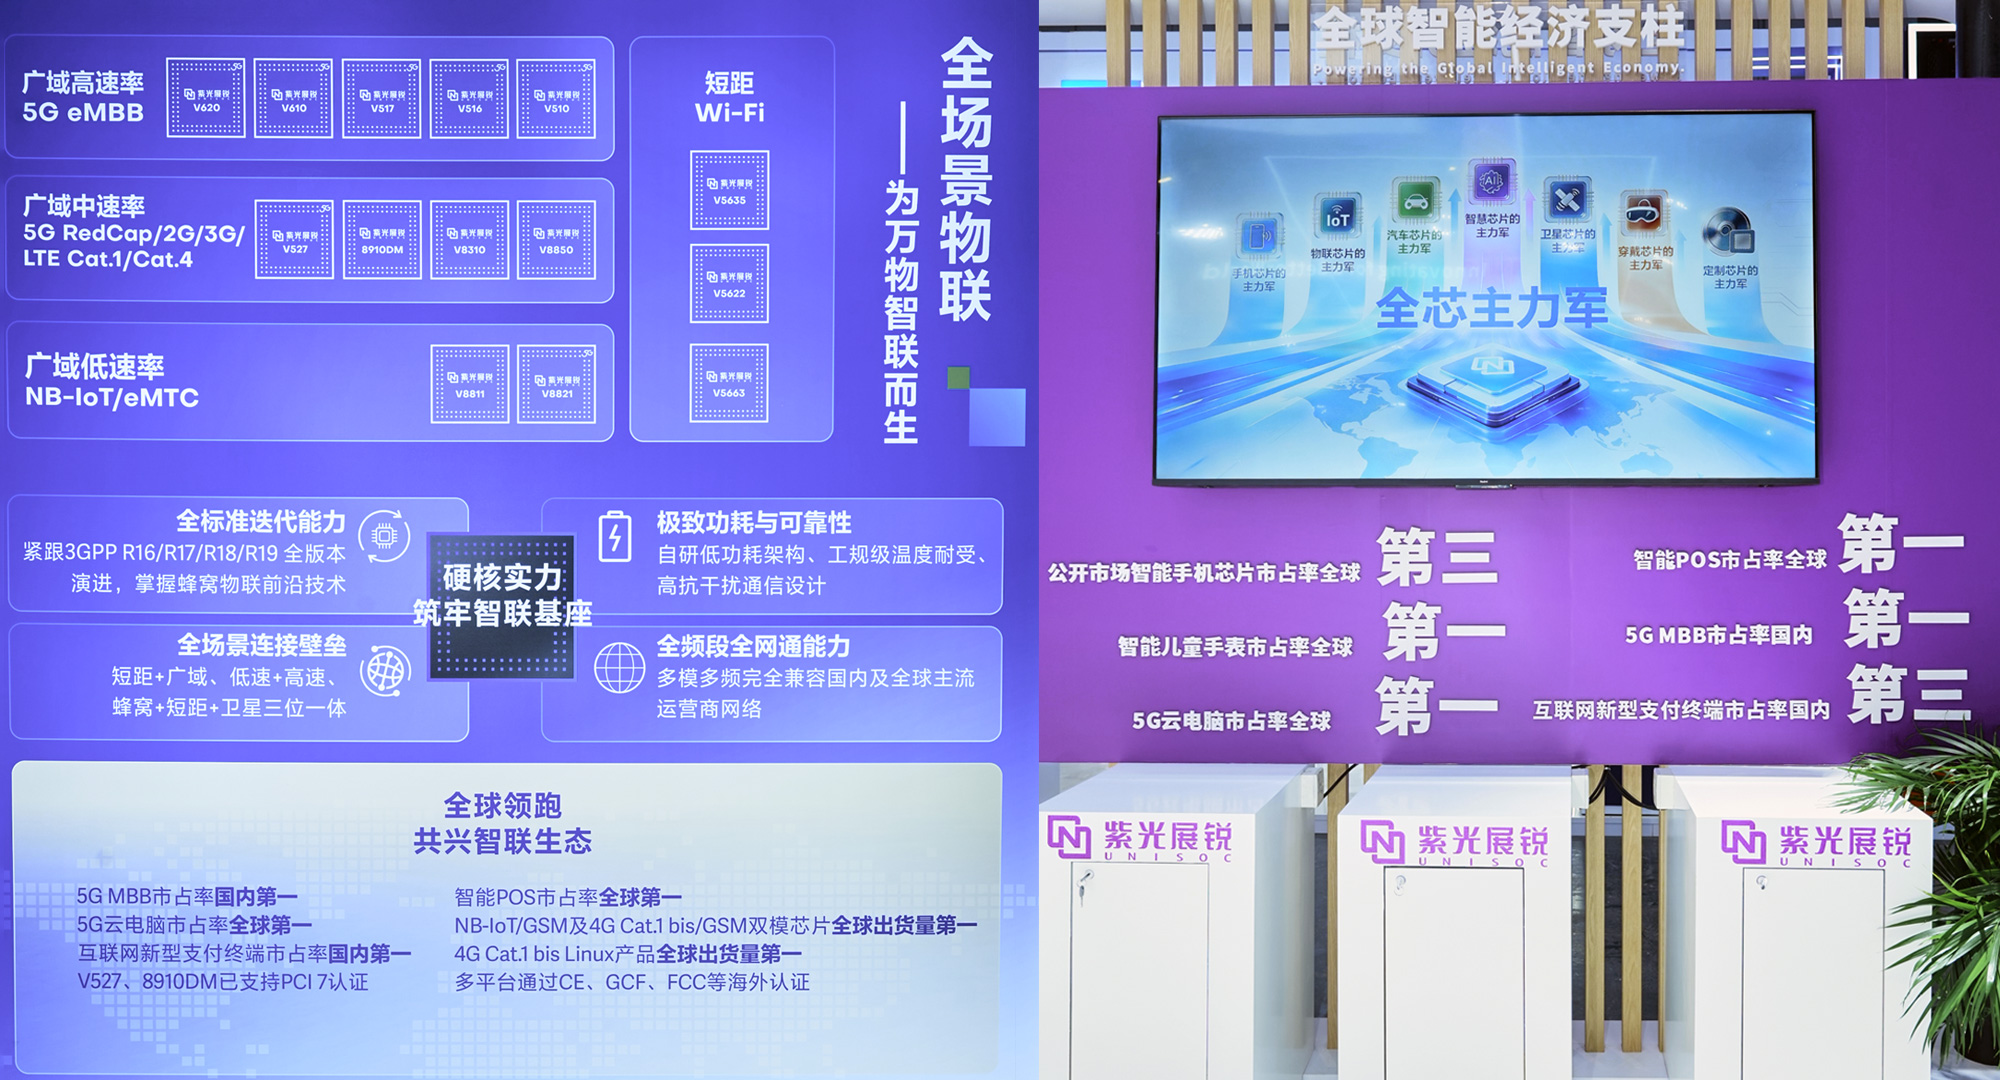
第一、全标准迭代能力。紫光展锐紧跟3GPP R16/R17/R18全版本演进节奏,完整跟进蜂窝通信国际标准迭代,核心技术演进与全球前沿标准保持同步,保障芯片协议栈、新特性的先进性与兼容性,让产品可以匹配全球不同运营商的5G、RedCap网络升级节奏。
第二、全场景连接壁垒。紫光展锐是业内稀缺的同时具备短距+广域、低速 +高速、蜂窝+短距+卫星三位一体连接能力的平台厂商,技术覆盖从2G到5G、从地面通信到空天地一体化,覆盖市面上全部物联网连接场景。
第三、极致功耗与可靠性能力。紫光展锐自研全套低功耗硬件架构,具备工规级宽温耐受能力、高抗干扰通信设计,芯片可稳定运行在工业现场、户外野外等高低温、强电磁干扰的严苛环境,兼顾消费终端与工业级设备的可靠性要求。
第四、全频段全网通能力。实现多模多频完整兼容,支持国内以及全球主流运营商的网络频段,不用针对不同地区做大规模硬件改板,为终端产品出海扫清网络适配障碍。
四大能力组合,让展锐芯既可以面向国内复杂行业场景,也能够直接适配全球多元化的网络环境,为产品矩阵、海外拓展、行业落地打下坚实技术根基。
完备产品矩阵,覆盖全速率物联场景
面向不同带宽、不同行业需求,紫光展锐搭建起层次清晰的物联芯片产品矩阵,覆盖 5G eMBB、5G RedCap、Wi-Fi 短距连接等主流赛道,形成旗舰、中端、入门完整梯队。
在5G eMBB 高速率赛道,V620、V610平台已经实现规模商用,面向FWA、工业互联等高带宽场景;新一代 V615、V660 也在推进研发迭代。其中V620依托R16标准能力,在海外多款5G CPE产品大批量出货;6nm工艺的V610主打高集成轻量化,适配电力物联网等空间受限设备。
5G RedCap中速率赛道,V527平台落地,面向工业、能源、物流场景,具备高精度授时、网络切片能力,已经进入广和通、通则康威等主流模组厂商方案,V525新产品也在同步规划推进。
在短距无线侧,Wi-Fi5/6 芯片已规模导入产业链,V5635四合一无线连接芯片实现 Wi-Fi、蓝牙、定位多制式融合;同时加速 Wi-Fi7、Wi-Fi8 产品研发,瞄准 PC、CPE 等高价值市场。
目前,紫光展锐物联芯片已深度绑定通则康威、广和通、美格智能、中兴、创维等国内主流模组与终端厂商,数十款模组、终端产品完成量产导入,完整分层的产品矩阵,为千行百业转型升级奠定了底座支撑。
加速海外拓展,收获全球市场认可
在多个细分赛道,紫光展锐已经拿下突出市场地位:5G MBB国内市占率第一、5G云电脑全球市占率第一、智能 POS 全球出货第一、NB-IoT、4G Cat.1bis 多条产品线出货规模位居全球前列。
在认证层面,V527、8910DM 等芯片拿到 PCI 7 认证,多平台完成 CE、GCF、FCC等海外准入认证,目前累计通过全球300余家运营商认证,业务覆盖130多个国家和地区,在非洲、东南亚、拉美等5G高速增长市场建立起先发优势。
值得说明的是,以V620为代表率先落地5G R16全套特性,为全球客户提供差异化、高竞争力的5G解决方案,持续拓宽5G行业应用边界,并已通过GCF/PTCRB, Vodafone和中国移动等行业和全球重要运营商认证,展现展锐物联芯片在全球市场的竞争力。
落地千行百业,释放芯片底座核心价值
海量出货的背后,是大量解决现实行业痛点的落地实践。展锐5G物联整体解决方案出货已经达到数百万套,服务超过100类行业终端。通过和模组、终端厂商深度协同,把芯片的连接、算力、安全能力转化为解决产业痛点的实际价值,打造出一批标杆落地案例。
案例一:紫光展锐×通则康威 ZLT S200 5G CPE
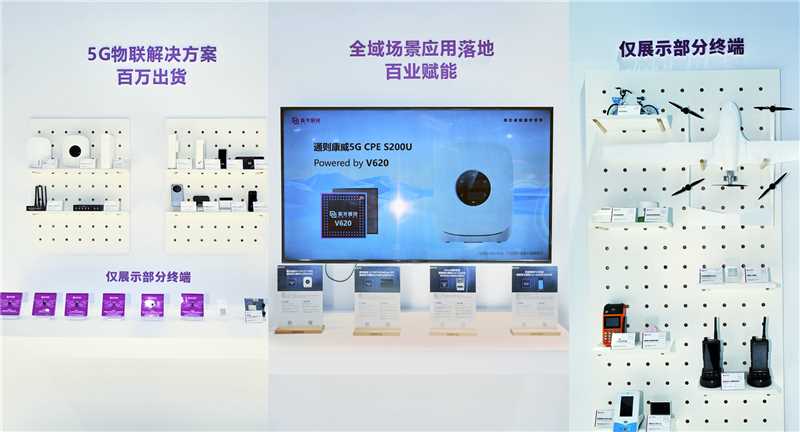
行业痛点:部分区域光纤覆盖不足、入户布线困难,传统固网存在单点断网、端口资源紧张、扩容慢、建设投入回报周期长等现实难题。
核心价值:依托V620芯片平台,提供“始终在线”的多千兆速率互联网接入服务。ZLT S200 实现多千兆级无线宽带接入,摆脱光纤布线束缚;同时可连接全球范围内的高带宽多模移动网络,支持外接天线,并配备LCD触摸屏,既能提升信号质量,又能简化管理操作。
案例二:紫光展锐×通则康威 ZLT M97 5G RedCap MiFi
行业痛点:传统 4G MiFi 带宽不足,早期5G便携终端成本高、功耗大;复杂环境多频段兼容性差,缺少芯片级安全管控与远程运维手段,企业运维成本居高不下。
核心价值:基于V527 RedCap芯片,兼顾220Mbps下行峰值性能与低功耗表现;支持完整远程升级、日志诊断。硬件层面做到便携低功耗,软件降低企业售后运维压力,为商铺、外勤作业提供高性价比5G移动接入入口,推动RedCap在消费与中小企业场景规模化普及。
案例三:紫光展锐×有方科技Genus智能电表
行业痛点:电力现场信号波动大,终端频繁掉线;抄表数据上报不及时;故障定位难,设备数量庞大带来巨大运维压力。
核心价值:以8910DM/V8850 系列芯片提供通信与计算底座,硬件基带保障复杂射频环境联网稳定性;内置TEE可信执行环境、安全启动,搭配加密算法,从芯片硬件筑牢数据安全防线。终端仅需简单AT指令即可对接云平台,实现稳定抄表、状态上报、故障告警,减少现场运维上门频次,助力电网能源数智化转型。
案例四:紫光展锐×联迪 P10 系列智能 POS
行业痛点:商业支付终端空间受限,成本压力突出;设备分散部署,版本迭代运维繁琐;支付行业对安全合规等级要求极高,设备需要适应商铺、流动摆摊等复杂使用环境。
核心价值:8910DM芯片提供四核算力、多模全网通通信,同时完成 PCI PTS 7.x安全认证;台式、无线共用一套芯片方案,商户按需选型;整机具备IP54 防护、抗跌落能力;支持 Android 长期维护与远程OTA升级。既保障交易流畅安全,又降低终端厂商开发、商户采购以及后期运维的综合成本,适配线上线下多元零售支付场景。
万物智联时代,连接不再只是简单的数据互通,而是对带宽、功耗、可靠性、安全性、全球化适配的综合考验。紫光展锐凭借标准同步的四大底层技术积累、完备的产品矩阵、持续突破的海外市场表现,以及垂直行业落地案例,确立了物联芯片主力军的行业地位。随着 5G RedCap、空天地一体化等新机遇到来,紫光展锐的未来发展值得期待。
2. 自研芯片围攻之下,GPU的护城河还剩多深?
谷歌、亚马逊,以及如今的OpenAI,都推出了颇具竞争力的AI芯片,并正在抢占市场份额。按制造商划分,GPU目前占全球已安装AI计算容量的70%,其余30%为定制芯片,主要来自谷歌和亚马逊。
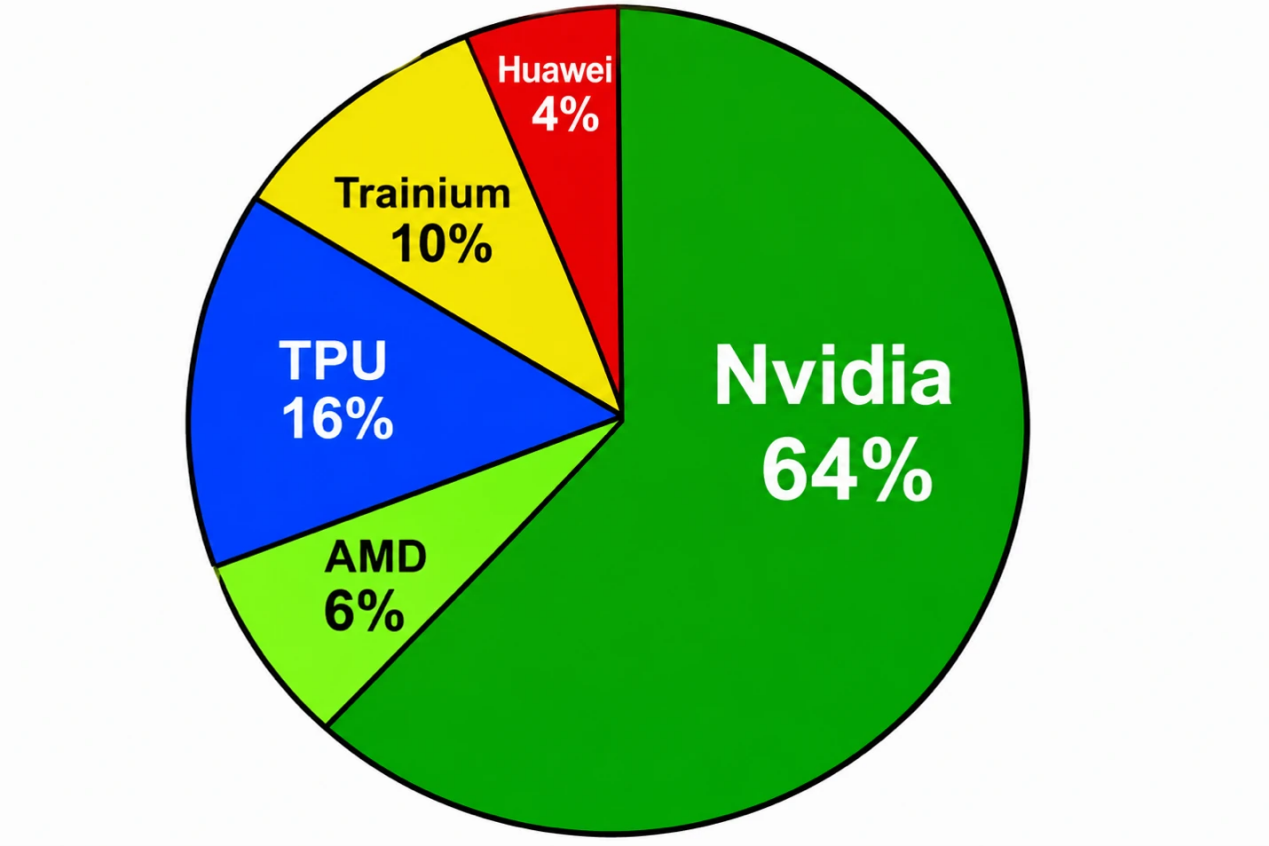
图1:当前全球已安装AI计算容量(按制造商划分)。来源:Epoch.ai
过去三年,全球已安装AI算力增长至原来的17倍。2023年,英伟达份额高达90%,谷歌仅占10%;三年过去,定制AI计算已抢下约20个百分点的份额。这一趋势会持续下去吗?(注:Epoch的数据未计入Meta、微软和Cerebras的AI算力,这几家体量相对较小。)
本文先看英伟达强大的产品阵容与近期的强劲增长预测;再审视超大规模云厂商与前沿模型开发商自研芯片的进展与优势;最后探讨在定制芯片性能逼近、竞争加剧的背景下,英伟达和AMD可以采取哪些举措守住份额。
英伟达:需求强劲,系统阵容完整
英伟达于8月26日发布财报,黄仁勋当天在接受CNBC采访时透露了以下要点:
•需求极其强劲,且仍在加速,令人难以置信;
•预计下一财年增长70%(受供应限制);
•AI现在正在为所有人赚钱,所以每个人都想要更多算力;
•一半业务来自超大规模云厂商,另一半来自Neocloud、主权客户等所有其他客户;
•GPU具有通用性,可在整个生命周期内使用,并运行所有模型;
•云服务商反馈,五年前购买的AI算力如今更加值钱;
•AWS将采购200万块GPU和数百万颗(Vera)CPU。
至于OpenAI的Jalapeño和其他竞争芯片,黄仁勋在接受《Mad Money》采访时回应:“我没问题。市面上有那么多XPU在发布,很多项目启动了,也有很多项目被取消了。我们会全力支持我们的合作伙伴。”
英伟达每一代新GPU的能效都远超前代。而且,英伟达提供的远不止GPU:NVL72纵向扩展网络、机架、低延迟推理方案(Groq 3 LPX)、面向智能体优化的Vera CPU、BlueField DPU,以及Spectrum-6 SPX横向扩展网络——所有组件协同设计、协同工作,带来远超单靠GPU的性能提升。在Hot Chips 2026上,英伟达围绕各类新芯片发表了五篇论文,约占全部论文的五分之一。
英伟达还在会上披露了Vera CPU的细节。Vera采用大得多的单线程核心,专为AI智能体的低延迟计算而优化。据该公司估计,其智能体工作负载性能可达传统CPU的1.8倍。
Vera Rubin已全面进入量产爬坡,整机机架已在CoreWeave、谷歌云、微软Azure、甲骨文云和Nebius投入运行。结合英伟达强劲的收入增长与明年再增70%的预测,Vera Rubin的量产爬坡有望在2026—2027年提升其在全球已安装AI算力中的份额。Hot Chips上,英伟达展示了Vera Rubin相对GB300的帕累托性能(见图2)。
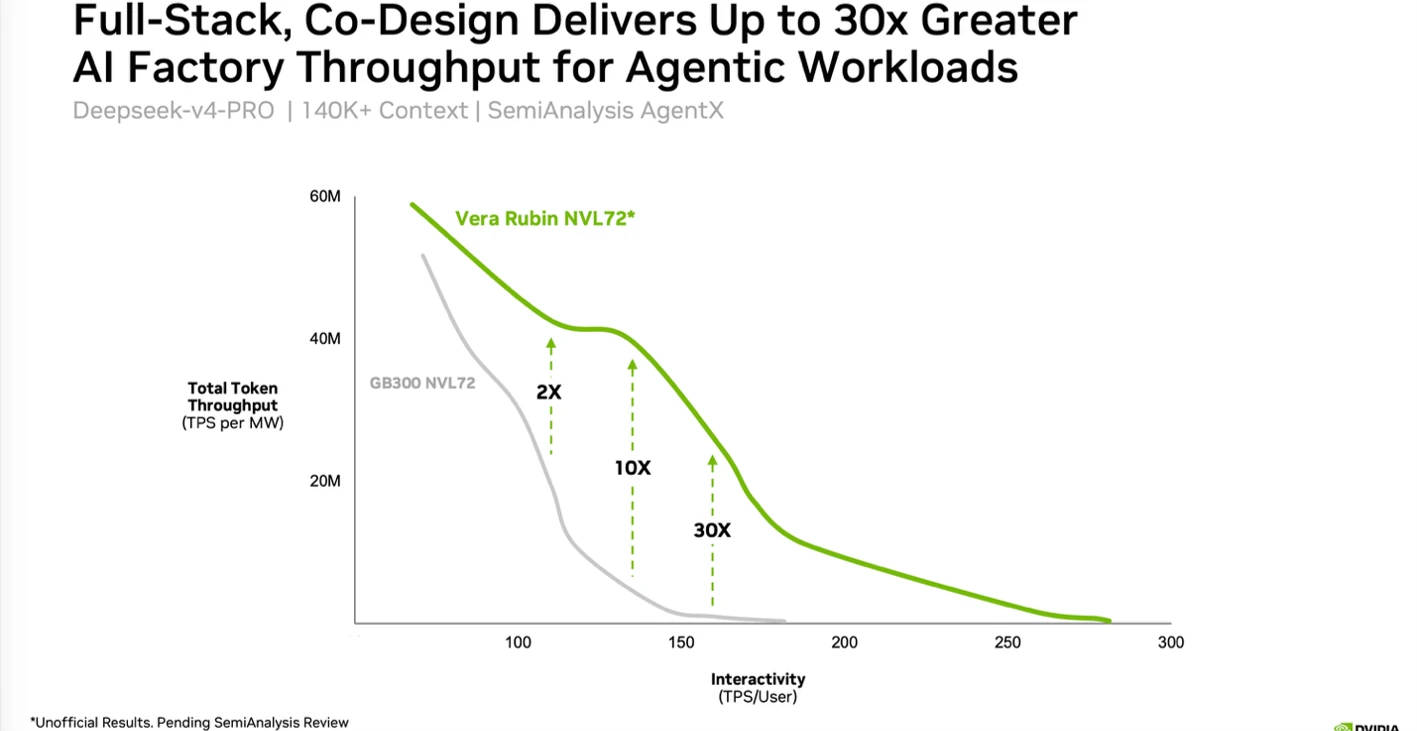
图2:Vera Rubin NVL72在DeepSeek-v4-PRO上的性能与GB300对比。来源:英伟达/Hot Chips 2026
电力是数据中心最稀缺的资源之一,因此运营商追求更高的TPS/MW(每瓦吞吐量);同时,许多客户希望超大模型也能实现极快响应,即更高的TPS/user(每用户吞吐量)。Vera Rubin两者兼得。交互性越高、价值越高,因此Vera Rubin相对GB300的优势恰恰在价值最高的场景中最为显著——高达30倍。这既源于众多GPU层面的创新,也离不开Vera这类配套创新。
去年,英伟达获得Groq的LPU技术授权并吸纳其团队,使LPU可作为协处理器与Vera Rubin协同工作,为最有价值的工作负载提供更快的低延迟响应。Hot Chips上,英伟达详细介绍了LPU的架构与编程,并展示了LPU与GPU协同的多种方式。如下方基准测试所示(此处使用GPT-OSS-2T而非DeepSeek),Vera Rubin+LPU大幅降低了推理延迟,显著提升了TPS/user。
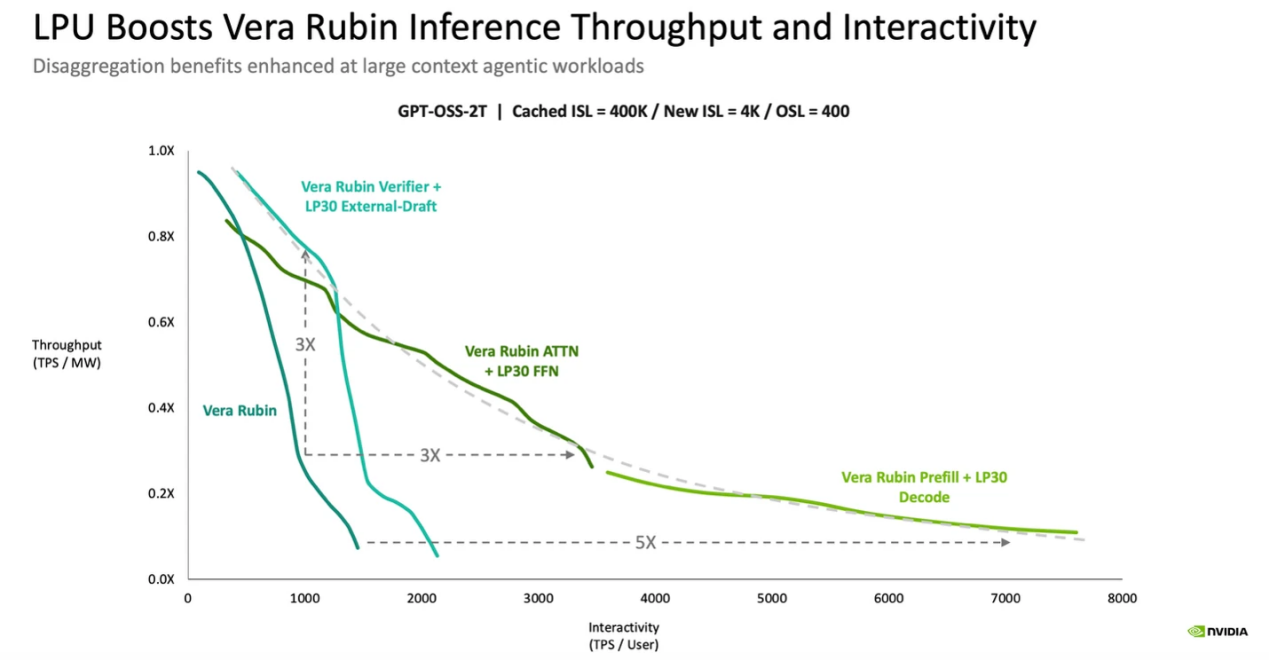
图3:LPU与Vera Rubin配合,同时提升TPS/MW和TPS/user。来源:英伟达/Hot Chips 2026
AMD MI455X与Helios
AMD围绕最新GPU和Helios机架进行了两场演示,性能规格较此前产品大幅跃升:纵向扩展域现已支持72块GPU,采用博通以太网交换机;Helios则是完整的机架级系统,与英伟达一样为客户提供一站式解决方案。短短几年间,AMD进步显著,全球已安装份额从0%升至6%。略有遗憾的是,AMD并未给出任何AI工作负载的性能数据。
自研芯片:模型开发商握有优势
Hot Chips上,Meta、微软和谷歌详细介绍了各自的下一代AI加速器;OpenAI则首次公开了其AI推理加速器Jalapeño,效果令人印象深刻。超大规模云厂商和前沿模型开发商承载着海量工作负载,自然希望把更多负载迁移到自己优化的芯片上。
模型开发商握有天然优势:他们比GPU厂商更了解自身工作负载,清楚训练与推理的比例,更清楚瓶颈所在和自己的战略方向;凭借庞大的已安装算力,也有条件对现有芯片、在研芯片特性乃至英伟达芯片进行详尽的基准测试。
在超大规模云厂商和模型开发商的总计算负载中,相当比例由自有模型消耗(含训练与推理服务);谷歌和亚马逊还一直在向客户提供、甚至直接销售TPU/Trainium,以推动云客户的工作负载从GPU迁移过来。
随着超大规模云厂商、OpenAI和Anthropic部署的算力规模增长了一个数量级,针对特定工作负载定制芯片已经具备经济性——第一步就是区分专用训练芯片与专用推理芯片。几年前,开发两款芯片的增量成本可能超过1亿美元(其中掩膜、工具和团队费用即超3,000万美元),令人望而却步;但在今天的规模下,如果优化后的芯片能以10%~30%的硅面积缩减,换取10%~30%的吞吐量/瓦提升,这笔投入就完全划算——毕竟在当前供应受限、且很可能延续到2030年的环境中,电力和晶圆才是最稀缺的资源。
OpenAI Jalapeño:首作即似可与Vera Rubin匹敌
Jalapeño是OpenAI的首款芯片,表现令人印象深刻。Jalapeño由一个小团队在短时间内开发完成,并大量借助OpenAI自己的AI工具提效。它针对OpenAI自身工作负载做了优化,但同样能运行任意模型用于推理。团队决定同时针对预填充和解码进行优化,并将KV Cache内存保留在本地。
他们指出,HBM内存的原始容量本应支撑更高的token速率,因此架构设计着力消除瓶颈,以充分释放HBM容量;团队预计每一代都会更进一步(第二代已在研发中)。
网络方面,他们采用博通Tomahawk 6交换机构建由128颗Jalapeño组成的域,再用更多Tomahawk交换机构建由2,048颗Jalapeño组成的全局域。
Jalapeño已测试数月,OpenAI分享了多项基准测试结果。
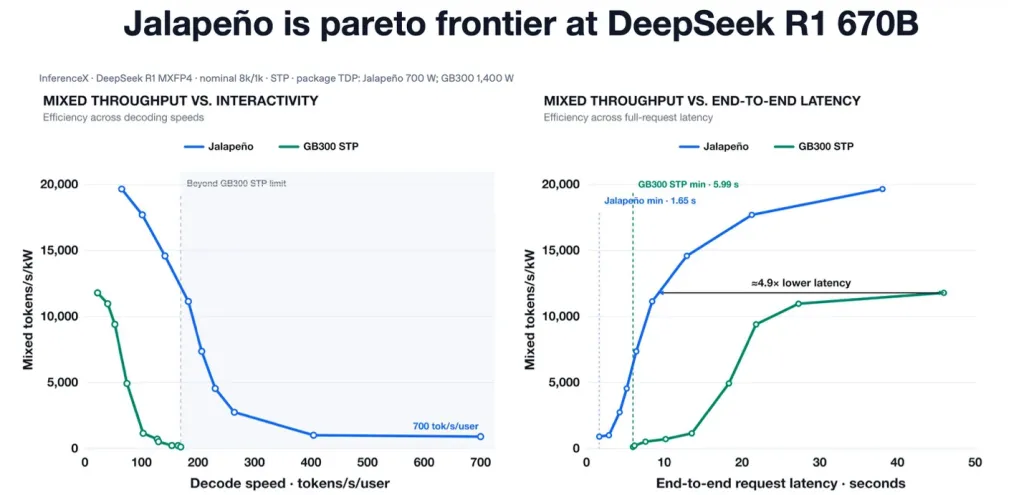
图4:DeepSeek在Jalapeño与英伟达GB300上的性能对比。来源:OpenAI/Hot Chips 2026
由于测试时间有限,Jalapeño的基准全部采用单token预测(STP);未来引入多token预测(MTP)后,性能有望再提升3~5倍。他们对GPT-OSS、DeepSeek R1和Kimi K2.5进行了测试,并与GB300的STP、MTP结果对比——Jalapeño在所有场景下都显著领先。
Jalapeño与Vera Rubin NVL72相比又如何?英伟达的演示显示,Vera Rubin比GB300快2~30倍(低交互性下2倍,极高交互性下30倍)。将GB300曲线按相应幅度平移,即大致接近Jalapeño的表现——据此粗略推断,Jalapeño足以与Vera Rubin一较高下。Hot Chips之后,SemiAnalysis发布分析,同样认为Jalapeño与Vera Rubin不相上下。
Anthropic:组建自研芯片团队
Anthropic近期为自研AI芯片项目聘用了OpenAI硬件团队的关键成员Clive Chan,并公开证实正在组建内部芯片团队、为Claude设计定制芯片,称这是“我们多芯片方案的最新一步”。
谷歌TPU 8t与8i
谷歌深耕AI计算已有十年:第一代TPU于2015年推出,面向推理;第二代TPU开始支持训练。此后,谷歌在训练与推理之间持续优化,通常隔年交替发力。
如今,谷歌同时推出面向训练的TPU 8t和面向推理的TPU 8i。业务规模增长了一个数量级,使并行开发两款芯片的成本变得可以承受,而充分利用稀缺电力与晶圆的回报也极具吸引力。TPU 8代性能约为前代的两倍。
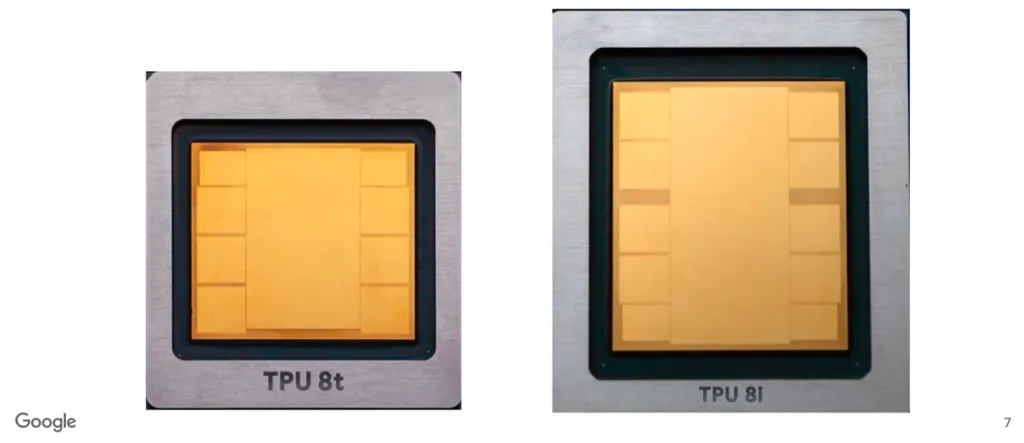
图5:TPU 8i因配备更多HBM,尺寸为TPU 8t的1.4倍。来源:谷歌/Hot Chips 2026
8i与8t的尺寸之差,直观体现了专用化带来的节省:若一颗芯片要兼顾推理与训练,可能需要比TPU 8i再大10%~20%,以容纳训练所需的全部反向传播逻辑。
TPU的主要用户包括Anthropic、OpenAI、Meta和苹果。
摩根士丹利最近估计,谷歌TPU销售额今年下半年将达90亿美元,2027年达840亿美元,2028年达1,080亿美元——相当可观。作为参照:英伟达最近一个季度营收960亿美元,预计下一季度达1,080亿美元,其中约90%来自数据中心业务。
谷歌云服务于极为广泛的客户与工作负载,其中许多仍将继续使用或需要英伟达GPU,但谷歌云正积极引导他们迁移至TPU。
Hot Chips 2026上的其他定制加速器
Meta的首款AI推理加速器MTIA用于加速Facebook、WhatsApp和Instagram背后的推荐系统模型。Meta指出,GPU并不适合其工作负载——其中包含数TB的稀疏嵌入表和大量内存受限操作。第二代加速器MTIA 300专为训练推荐模型设计,目前在大批量训练中的每美元性能已略高于GPU;MTIA 400正在研发中,面向生成式AI与推荐系统。Meta的路线图显示,大约每六个月就会推出更多芯片。Meta最了解自身工作负载与瓶颈,因此能设计硬件精准发力。
与此同时,Cerebras发布了CS-4:token/用户速度为上一代CS-3的2倍,吞吐量/瓦最高可达10倍,这对追求最低延迟推理的客户极具吸引力。该公司表示,CS-5将在一年内让性能再翻倍,CS-6则会在下一年借助3D堆叠DRAM再翻一番。
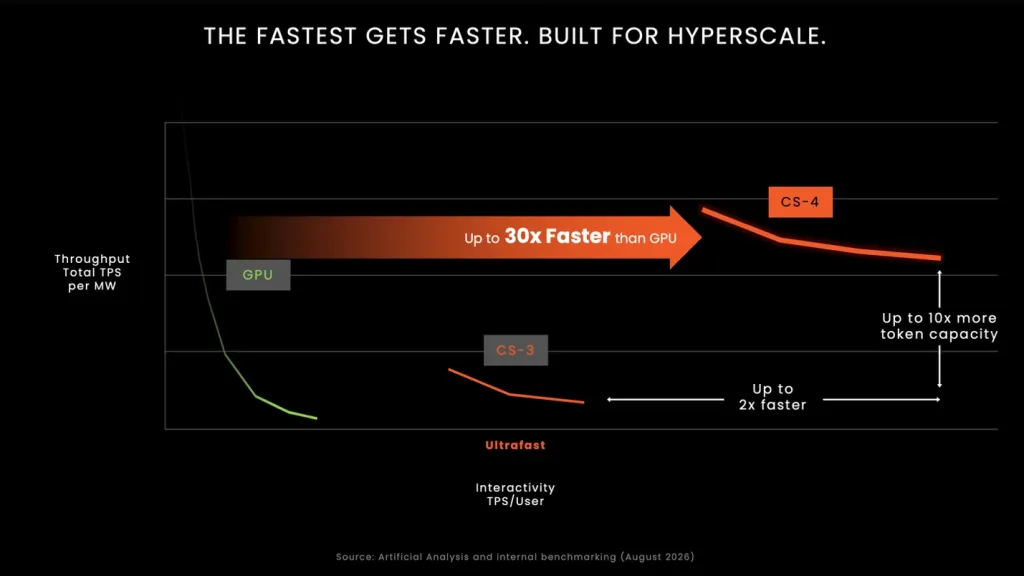
图6:Cerebras CS-4在容量增至10倍的情况下,将低延迟TPS/用户提升一倍。来源:Hot Chips 2026
此外,微软、SambaNova和D-Matrix也展示了各自的最新AI计算芯片。
GPU厂商如何守住份额?
英伟达每年在技术研发和产品迭代上的投入已超过任何一家定制AI芯片开发商,强劲的收入增长还将带来更充裕的现金。
英伟达正以资本锁定供应。在最近的财报电话会议上,该公司管理层表示供应承诺已从1,190亿美元增至2,790亿美元,翻了一倍多。凭借与台积电的稳固关系以及在内存采购上的雄厚财力,英伟达很可能在未来几年内保持主导供应商地位,最大限度获取稀缺资源。
即便如此,英伟达仍受供应约束。正如其CFO在财报电话会上所言,若无供应限制,明年70%的需求增长可能会更高。供应端最大的瓶颈,可能是台积电的晶圆分配和HBM供应。
对此,英伟达可以分别推出专用训练芯片与专用推理芯片,更充分地利用稀缺资源;以其打造复杂芯片的能力,甚至可在两者之外再保留一款通用GPU。
AMD则可以考虑收购Cerebras(其市值仅为AMD的十分之一),为需要超低延迟推理的客户提供类LPU方案;或者,Etched等众多AI算力初创公司之一,也可能以更低成本提供类似能力。
谷歌表示,OCS(Optical Circuit Switching,光电路交换)是其优势的重要组成部分。英伟达和(或)AMD可以引入OCS,改进各自的横向扩展乃至纵向扩展网络。当前铜互连已逼近极限,GPU性能的进一步提升离不开光互连;超大规模云厂商态度谨慎,预计会优先采用风险较低的NPO,但NPO无法企及CPO的性能水平。英伟达和(或)AMD若能率先将CPO集成到GPU上,便可提供竞争对手难以匹敌的性能。(利益披露:笔者分别任职于某OCS公司和某光引擎公司的董事会。)
模型开发商因亲自开发模型,在构建推理方面更具优势。英伟达已投资开发Nemotron等开放权重免费模型——在Open Router最常用免费模型榜单中占据前四名中的三席;最近还与Poolside达成70亿美元的交易,获得其开放权重模型授权,并吸纳其逾百名工程师。免费模型并不直接创收,黄仁勋想必是看中了其中蕴含的洞察力与客户参与度。
结论
英伟达拥有强大的护城河,但它面对的也是资源极其雄厚的客户。随着晶圆和HBM供应在2~5年内超过需求,英伟达(以及AMD)面临的真正挑战将是:部分客户有能力开发并使用自研AI算力来运行自有工作负载。
Anthropic和OpenAI的工作负载100%属于自己;谷歌和Meta的负载可能大部分自有;亚马逊和微软的负载则主要来自其客户。英伟达和AMD必须继续全力奔跑,才能跑赢客户的自研芯片雄心。如果Jalapeño最终在生产部署中被证实与Vera Rubin相当(甚至更好),那将对GPU阵营敲响重大警钟。
参考链接:https://semiengineering.com/can-gpus-continue-to-dominate-ai-compute/
3. DeepSeek开源“推理发动机”DeepInfer:155万亿Token/天的吞吐秘密(兼容英伟达SM100与华为昇腾950,推理降本从“模型”走向“系统工程”)
2026年10月20日,DeepSeek宣布全面开源内部生产级推理框架DeepInfer(Apache 2.0协议),并同步开源生产级Token编解码组件deepseek-recipe(MIT协议)。据DeepSeek披露,基于DeepInfer运行的DeepSeek V4.1 Flash,单一集群服务吞吐量已达每天155万亿Token,按谷电价计算平均每卡每小时收入38美元;输入缓存命中率96%,平均单请求输入77K Token,首字时延约400毫秒,单用户解码速度230 Token/秒。
这是继开源大模型权重、TileLang编译工具、FlashMLA与DeepGEMM等算子库之后,DeepSeek首次将“如何以合理成本服务海量用户”的推理中间层完整开源。对行业而言,开源竞争正在从“模型参数”这一层,蔓延到决定服务成本的“推理系统”这一层。
1 事件背景:从模型、算子到框架的开源三部曲
1.1 开源版图补齐“框架”拼图
DeepSeek的开源路线已持续一年多:从V3、R1到V4系列模型权重(MIT协议),到对标CUDA的TileLang编译平台,再到FlashMLA(MLA解码内核)、DeepEP(高性能通信库)、DeepGEMM(矩阵乘代码库)、3FS(分布式文件系统)等底层组件;2026年6月,DeepSeek又与北京大学联合发布DSpark推测解码框架。10月17日,V4.1 Flash更新至V4.1-Flash-1017版本,网页端、APP与API同步变更。三天后的10月20日,支撑这套服务运行的推理框架DeepInfer与编解码组件deepseek-recipe正式开源,把开源版图的最后一块拼图——“推理框架”——交到了社区手中。
1.2 两个开源项目的定位
DeepInfer是DeepSeek生产级大规模推理服务的核心框架,以Apache 2.0协议发布,当前支持DeepSeek-V4.1-Flash,默认checkpoint为deepseek-ai/DeepSeek-V4.1-Flash-1017。项目最初主要基于vLLM构建,并借鉴SGLang与TensorRT-LLM的设计思路,整合FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect等自研算子与TileLang内核。deepseek-recipe以MIT协议发布,负责主流API协议与模型Token序列之间的编解码转换,目标是让第三方部署获得与官方一致的接口体验。
2 技术拆解:DeepInfer如何把吞吐做到极致
2.1 PD分离:8卡Prefill与64—128卡Decode
Prefill(预填充)与Decode(解码)两阶段的计算特征差异显著:Prefill一次性处理数万Token,以算力密集型为主;Decode逐Token生成,主要受显存带宽约束。DeepSeek将两者分离部署:Prefill使用常见的8卡服务器(专家并行EP2—8、数据并行DP2—8),Decode使用64至128卡超节点(EP64—128、DP64—128的Wide-EP),并分别优化首字时延(TTFT)与逐字间隔(TBT)。在生产集群中,Prefill与Decode的卡数配比接近1:1;按技术报告口径,最小可一组Prefill加一组Decode运行,高效起步规模约为64卡Prefill加64卡Decode。
2.2 两级KVCache:3FS持久化、内存短缓存与Bounded Replay
缓存复用是DeepInfer降本的另一个关键设计。DeepSeek V4.1 Flash将KVCache分为Block与SWA两级:Block KVCache按128 Token切块,存入独立的3FS分布式文件系统(约100 PiB SSD,峰值聚合读取带宽约10 TiB/s、写入约850 GiB/s),按Agent流量保留3天、聊天流量保留7天的策略留存,设计目标是缓存不活跃后保存72小时以上;SWA KVCache只留在机器内存中、不做持久化,线上保留时间约180秒、命中率超过98%。当SWA KVCache未命中时,SWA Bounded Replay机制只重算最近128个Token(默认配置保留140个Token),并将注意力窗口限制在重算区间内,把缓存缺失的额外计算成本压到最低。DeepSeek在技术报告中披露,这一设计使Decoder侧的Prefill计算量近乎减半。
2.3 DSpark变长验证与异步调度
DeepSeek采用DSpark投机解码框架:草稿Token的验证范围不再固定,而是根据候选Token的预期接受概率动态决定——Confidence Head按置信度分配验证算力,并以低秩logit bias校正草稿模型偏差。在线部署中,相比固定验证5个Token,变长验证使吞吐提升约6%。调度环节则通过CPU与GPU异步协作,让请求调度、前向计算与采样尽可能重叠,减少设备空转;同时支持批量无关推理、确定性采样,以及基于JSON Schema、正则表达式、EBNF语法的结构化输出。
2.4 deepseek-recipe:统一三种主流API协议
deepseek-recipe将OpenAI Chat Completions API、OpenAI Responses API与Anthropic Messages API统一转换为同一种对话格式,再按模型版本拼接Prompt并编码为Token,模型输出再流式转回对应格式。它同时解决两类工程问题:一是防止注入——用户在输入中手写的特殊Token会被当作普通文本编码,不会被识别为对话结构标记;二是加速编码——特殊Token位置在拼接时已确定,其间普通文本可分段并行编码,缩短长上下文请求的分词时间(核心路径用Rust实现)。流式输出侧则以跨Chunk状态机缓冲不完整的UTF-8码点,工具参数按DSML边界直接输出JSON片段、边生成边返回。
2.5 硬件适配与开源边界
DeepInfer同时适配英伟达SM100 GPU与华为昇腾950 NPU:NVIDIA侧要求CUDA 13,昇腾侧要求CANN 9.2,并分别提供requirements-nvidia.txt与requirements-ascend.txt。不过,本次开源并未覆盖全部生产组件:KV缓存系统、编码器/Prefill/Decode分离(VE分离)与数据并行副本间的负载均衡,因与DeepSeek内部基础设施耦合较深而未随本版发布。
3 数据透视:一组“经营级”指标的行业含义
DeepSeek在技术报告中披露的线上数据,罕见地把推理系统的衡量单位从“算力”扩展到了“经营”:单集群日吞吐155万亿Token、每卡每小时收入38美元(按谷价)、Prefill与Decode算力配比接近1:1。这组数据(见表1)直接回应了行业最关心的三个问题:吞吐能压到多高、延迟能压到多低、单位算力能产生多少收入。
表 1 DeepSeek V4.1 Flash线上运行关键数据
指标 | 数值 | 说明 |
单集群服务吞吐 | 155万亿Token/天 | 全集群口径 |
输入缓存命中率 | 96% | Prefill阶段 |
平均输入长度 | 77K Token | 单请求平均 |
首字时延 平均/P99 | 400/1000毫秒 | TTFT |
单用户生成速度 | 230 Token/秒 | 代码场景约300 |
每卡吞吐(不计缓存命中) | 60K Token/秒 | Prefill |
每卡吞吐(计入缓存命中) | 1.5M Token/秒 | Prefill |
Decode每卡吞吐 | 14K Token/秒 | Decode |
Prefill与Decode配比 | 约1:1 | 卡数比例 |
每卡每小时收入 | 38美元 | 按谷电价 |
KVCache保留(设计目标) | 72小时 | 不活跃后 |
数据来源:DeepSeek技术报告《DeepSeek V4.1 Flash大规模推理部署实践》(2026-10-20)
拆解来看:96%的输入缓存命中率意味着,在平均77K Token的长输入里,绝大多数内容直接命中先前计算、不必重复Prefill;计入缓存命中后,单卡Prefill有效吞吐从60K Token/秒提升到1.5M Token/秒,放大约25倍。38美元的每卡小时收入,则把推理效率换算成了可比较的经营指标——结合Gartner关于全球AI优化型IaaS支出2026年将增长96%、达420亿美元的预测,推理侧已成为AI基础设施资本开支的主战场。
4 行业影响与边界
4.1 推理成本曲线:开源与预测同向
从行业趋势看,推理成本正在经历快速下降:Gartner预测,到2030年在1万亿参数LLM上执行推理的成本将较2025年下降超过90%,LLM单位成本效益将是2022年同类模型的约100倍。TrendForce则预计,受北美CSP大举采购NVIDIA GB与Rubin整柜方案的带动,2026年AI推理算力将较2025年跃升约122%(按FP4/NVFP4口径)。DeepInfer的开源,把头部模型厂商验证过的“PD分离+KVCache复用+投机解码”方法论下放给社区,理论上会加速推理成本曲线的下行——尤其是把“每卡每小时38美元(谷价)”背后的系统设计逻辑公开化。
4.2 私有化部署与国产算力生态
对开发者与企业而言,DeepInfer降低了构建私有化与公有云推理服务的门槛:此前开源社区的推理栈(如vLLM、SGLang)与头部厂商的生产系统之间存在明显差距,而DeepInfer把MoE专家并行与负载均衡、推测解码、异步调度、结构化输出等生产级能力直接开源。对国产算力生态,DeepInfer提供昇腾950适配与requirements-ascend.txt,与DeepSeek此前在内蒙古乌兰察布规划大规模部署华为昇腾950DT加速器、以推理任务为主的路线相互印证,为昇腾平台上的大模型推理提供了一套经过生产验证的软件栈。
4.3 未开源组件与落地限制
需要指出的是,DeepInfer的开源仍保留边界:KV缓存系统、编码器/Prefill/Decode分离与数据并行副本间的负载均衡未随本版发布,这意味着社区拿到的是“引擎”而非完整的“生产系统”。同时,框架当前仅支持DeepSeek-V4.1-Flash单一模型,环境要求Linux、GCC 13以上与Python 3.12。从公开仓库状态看,项目发布后短时间内即获得大量星标与关注,社区反馈活跃;后续支持模型范围的扩展与未开源组件的补齐速度,将是衡量这次开源影响力的关键变量。
5 结语
DeepSeek将内部推理框架开源,是“训练使模型学有所成,推理则让模型为人所用”这句表态的技术落地。当单集群日吞吐达到155万亿Token、每卡每小时收入达到38美元(谷价)时,推理成本的控制早已不只是模型架构问题,而是算子、通信、调度与缓存管理共同决定的系统工程。DeepInfer的开源,让这套系统工程的方法论第一次完整呈现在社区面前。可以预期,推理基础设施的开源化将与模型开源一样,成为降低AI使用成本、扩大服务范围的重要杠杆;而DeepSeek能否持续把新模型的推理代码与新优化同步开源,将决定这份“开源红利”的成色。
4. 工业和信息化部:推动人工智能深度赋能新型工业化
10月19日,国务院新闻办公室举行新闻发布会,介绍加快推进科技兴商有关情况,并答记者问。工业和信息化部科技司司长魏巍介绍,坚持产业发展和应用促进两手抓,推动人工智能深度赋能新型工业化。根据测算,2025年我国人工智能核心产业规模超1.2万亿元。(来源: 新华网)
5. 重仅1克 我国科学家研制世界最轻无线介观显微镜
如何在自然、群体行为中清楚“看到”大脑神经元对复杂行为的调控,是理解智能的重要基础。我国科学家研制出目前世界最轻无线介观显微镜,重量仅1克,可在6毫米视场内以单细胞分辨率记录小鼠大脑皮层的神经活动,单只小鼠可同时记录8500多个神经元,是现有同类型设备的25倍。该成果19日在线发表于《自然》。
让显微镜同时能“看得广、看得清、戴得轻、不拴线”是神经科学研究的一大挑战。现有能分辨单个神经元的显微镜虽看得清,但往往需将小鼠头部固定在仪器下或用线缆将其“拴”住,但这样很难研究动物的一些复杂自然行为;头戴式微型显微镜虽不用给动物拴线,但视场通常不足1毫米,仅能看到很小一块脑区。想要同时覆盖更大范围皮层又要有更高清分辨率,就需要更重且更大功耗的显微镜。
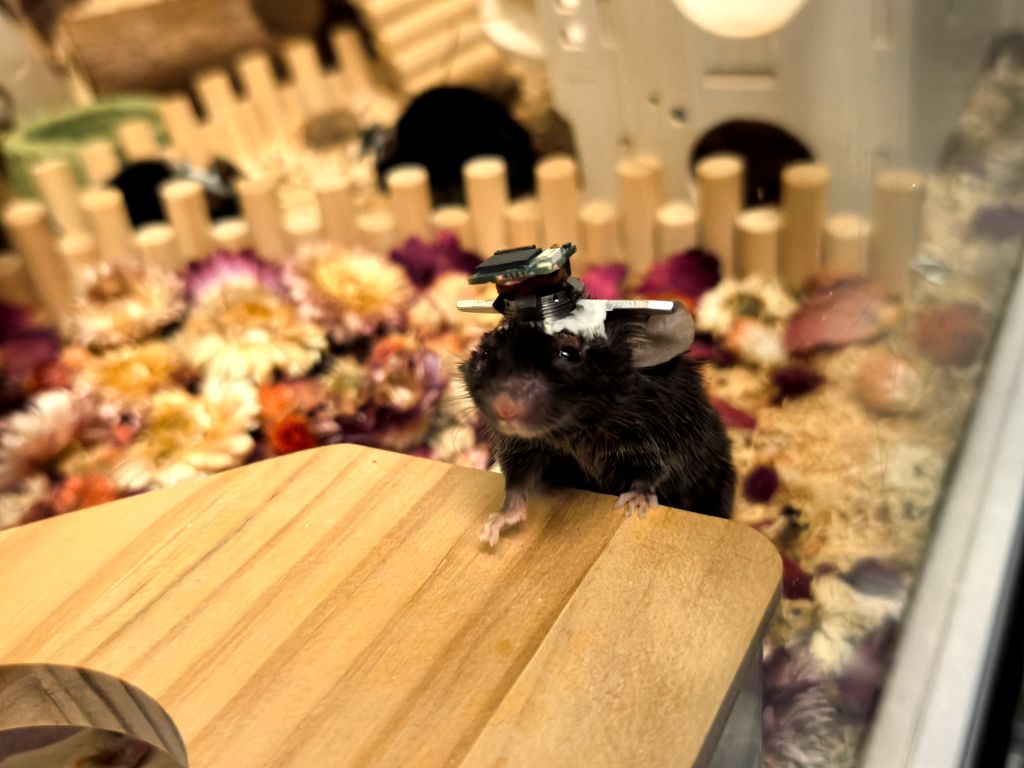
图为佩戴Airscope的小鼠在实验室搭建场景中自由探索。新华社记者魏梦佳 摄
为此,中国工程院院士、清华大学教授戴琼海团队与解放军总医院戴朴团队合作,通过集成化设计和系统性优化,研制出超轻无线介观显微镜Airscope,仅用4片非球面镜片,就在6毫米视场内实现单细胞分辨率(即4至6微米)的观测。
“无线、轻巧、宽视场、高通量是Airscope的显著特点。”清华大学自动化系副教授吴嘉敏介绍,常规头戴式微型显微镜重量通常超过3克,会影响小鼠自由活动。而Airscope不仅摆脱了线缆束缚,尺寸更轻巧,还通过200万像素图像传感器实现端侧压缩,使百万像素级图像得以无线传输。
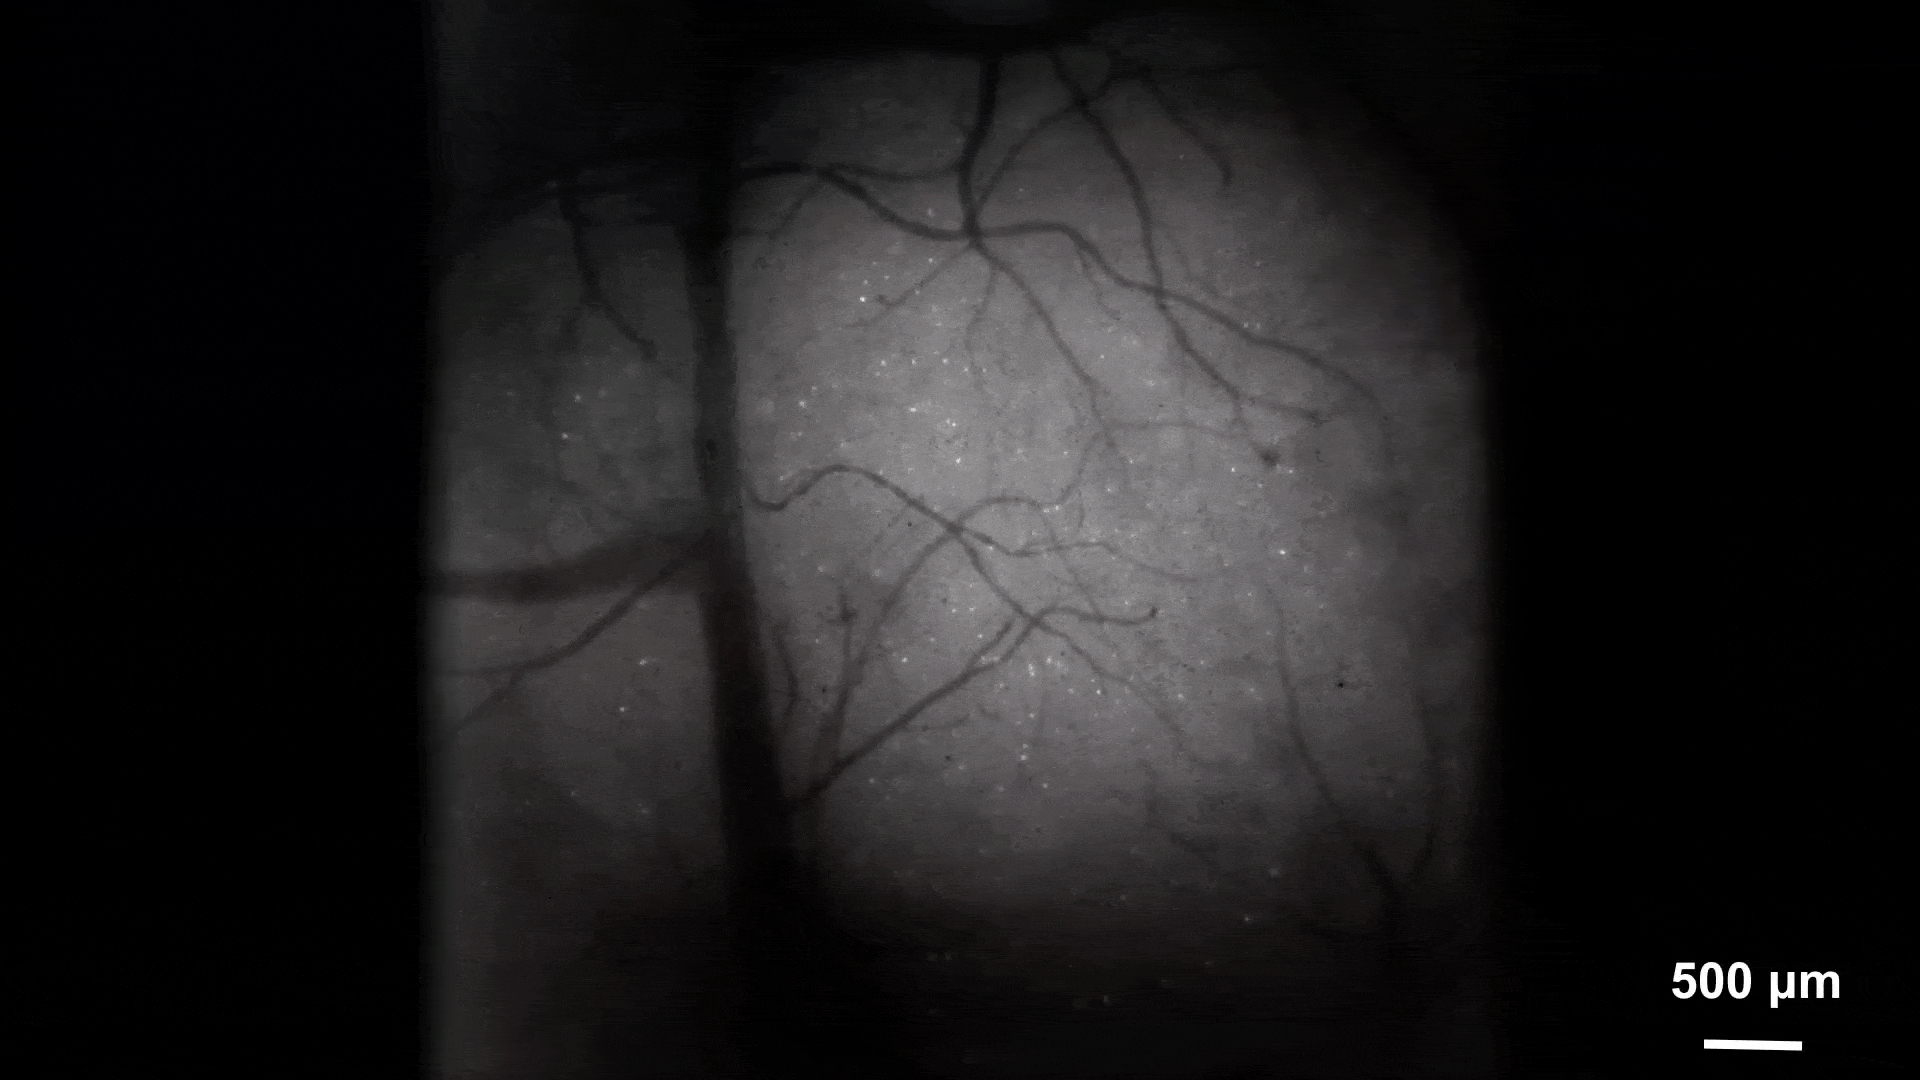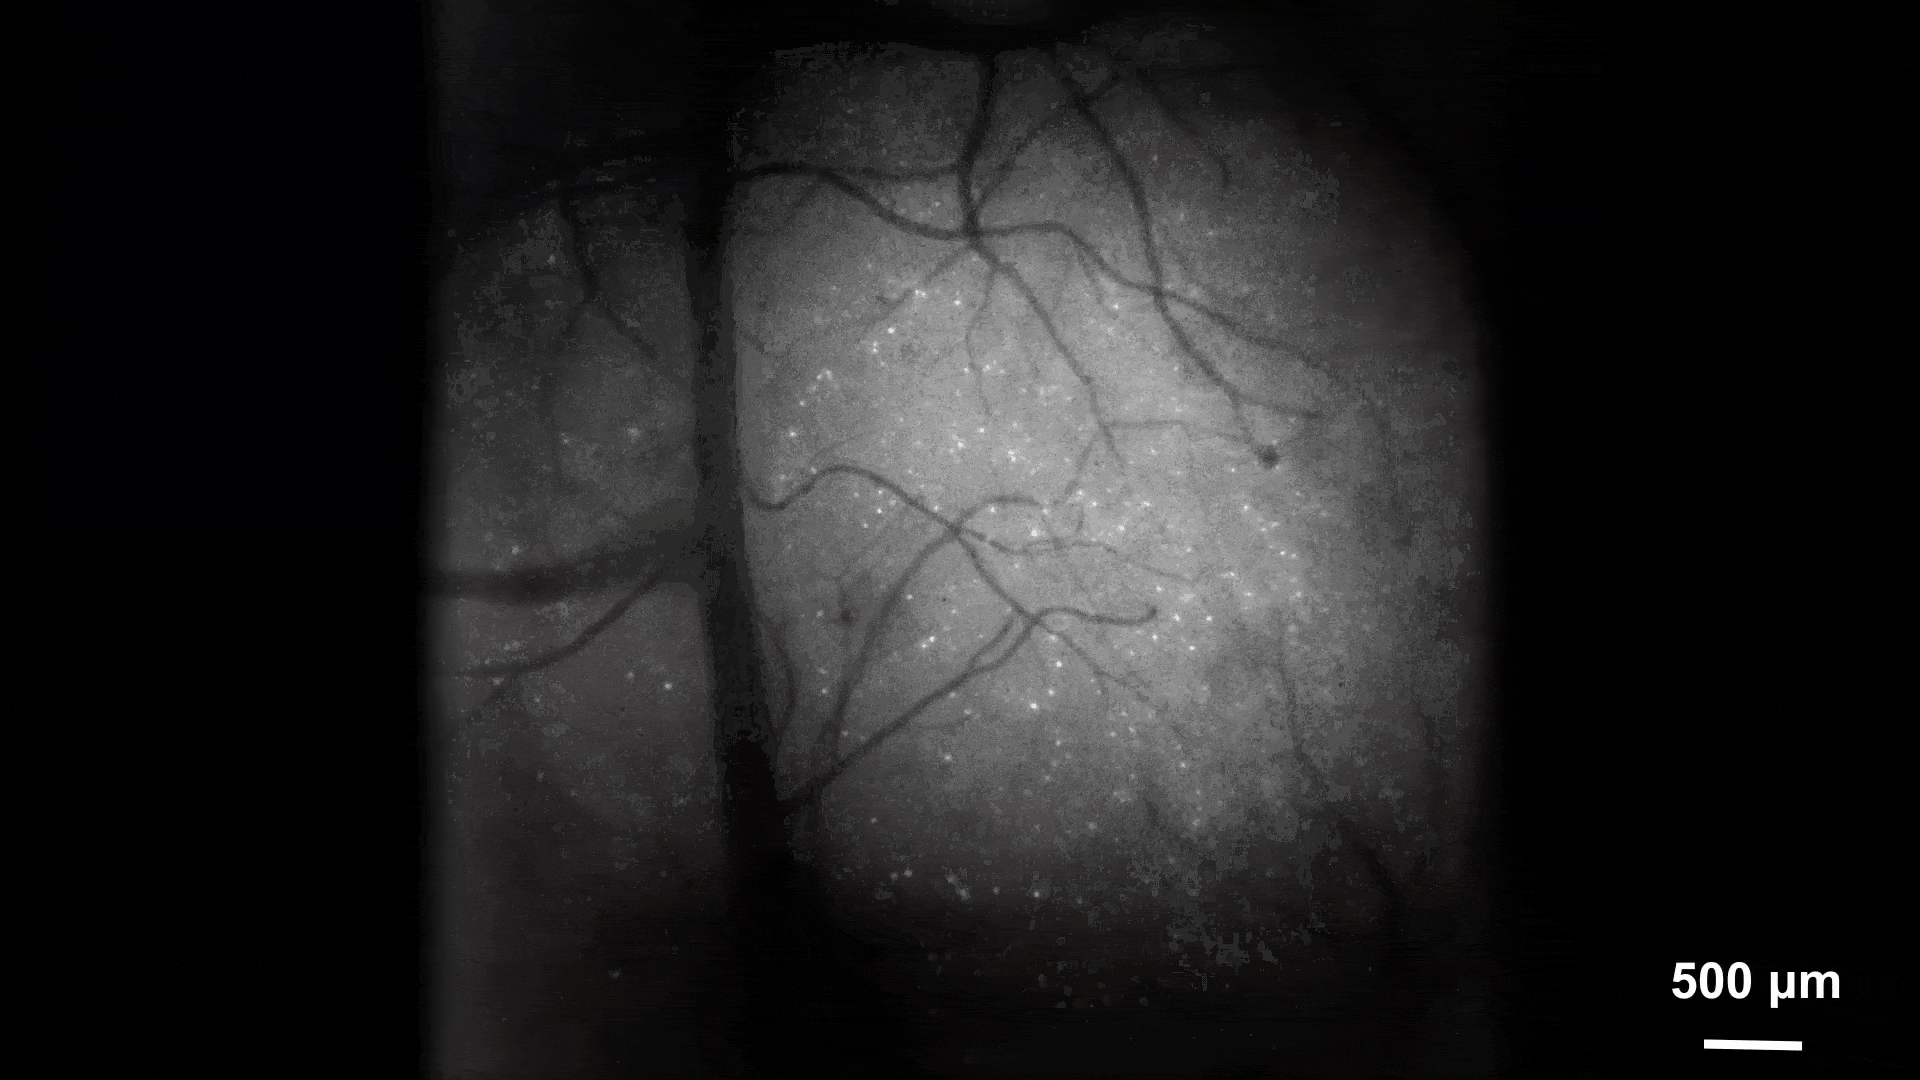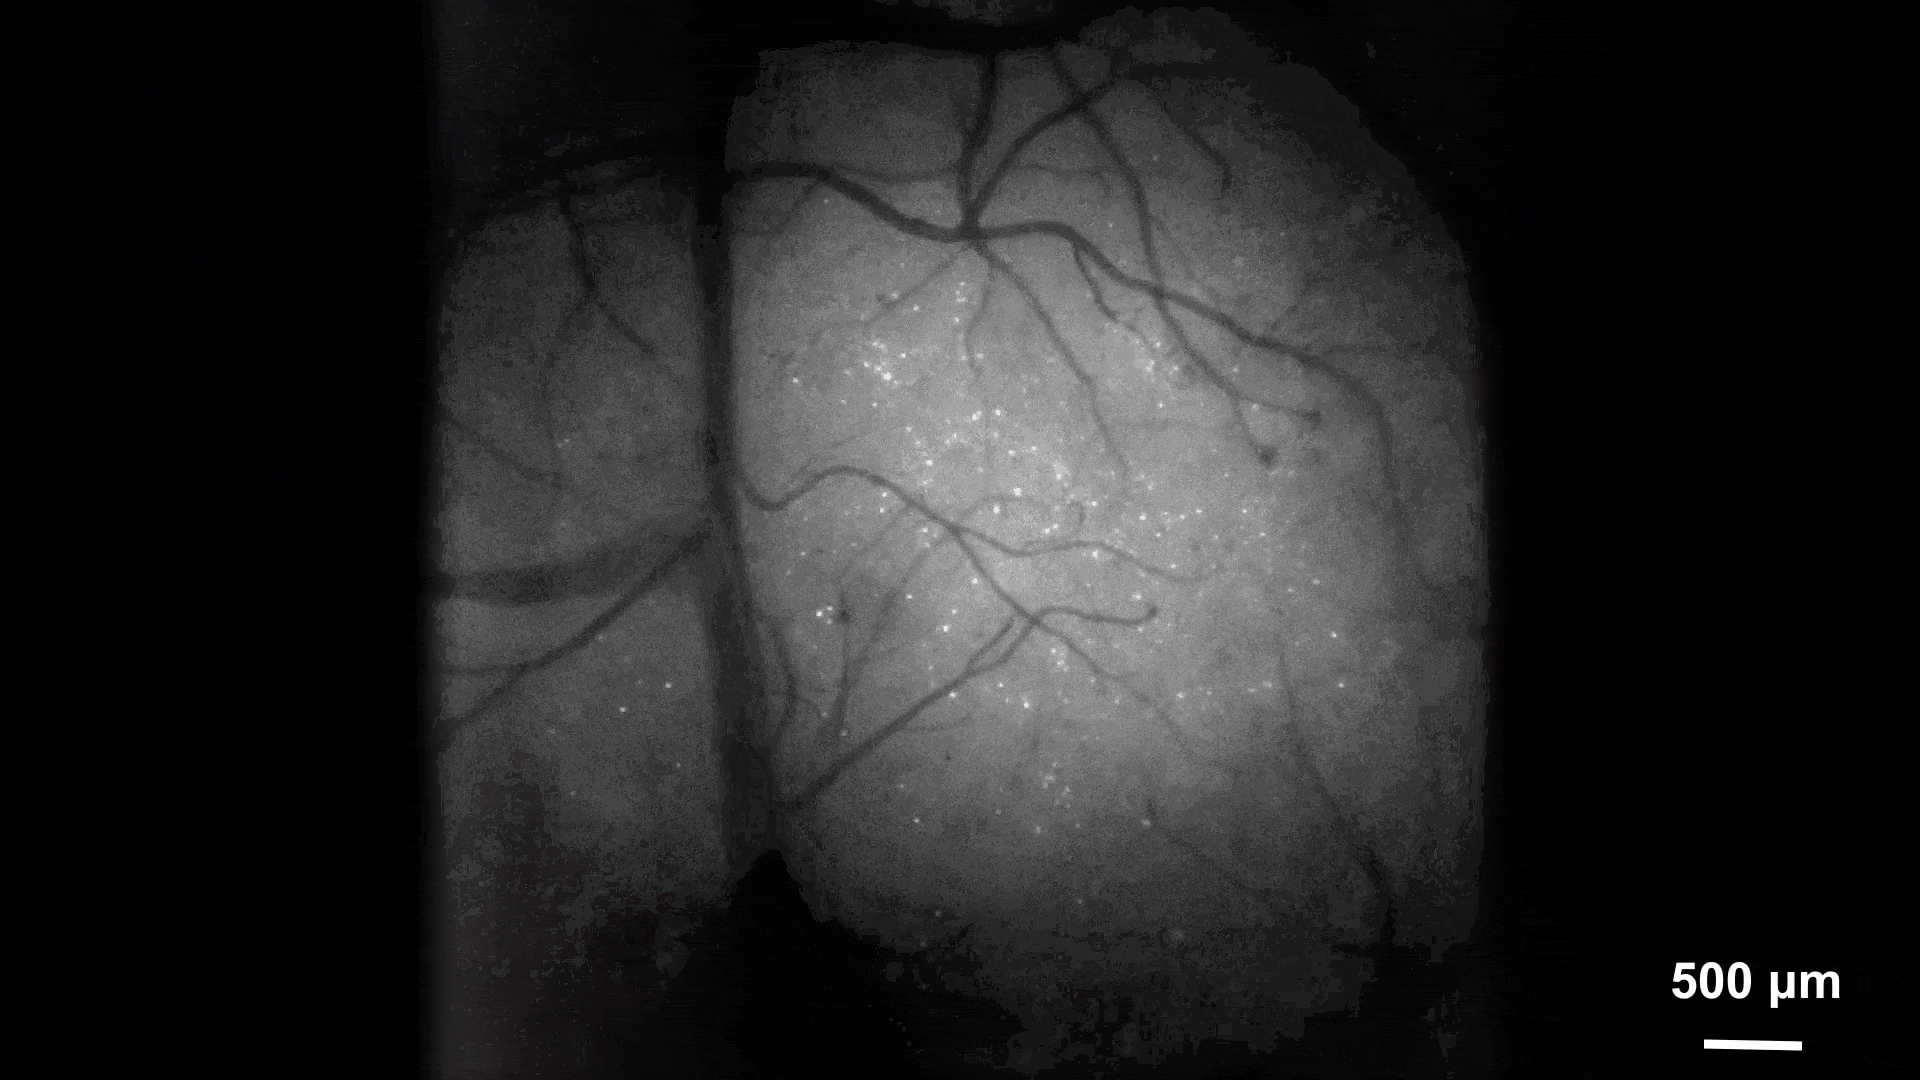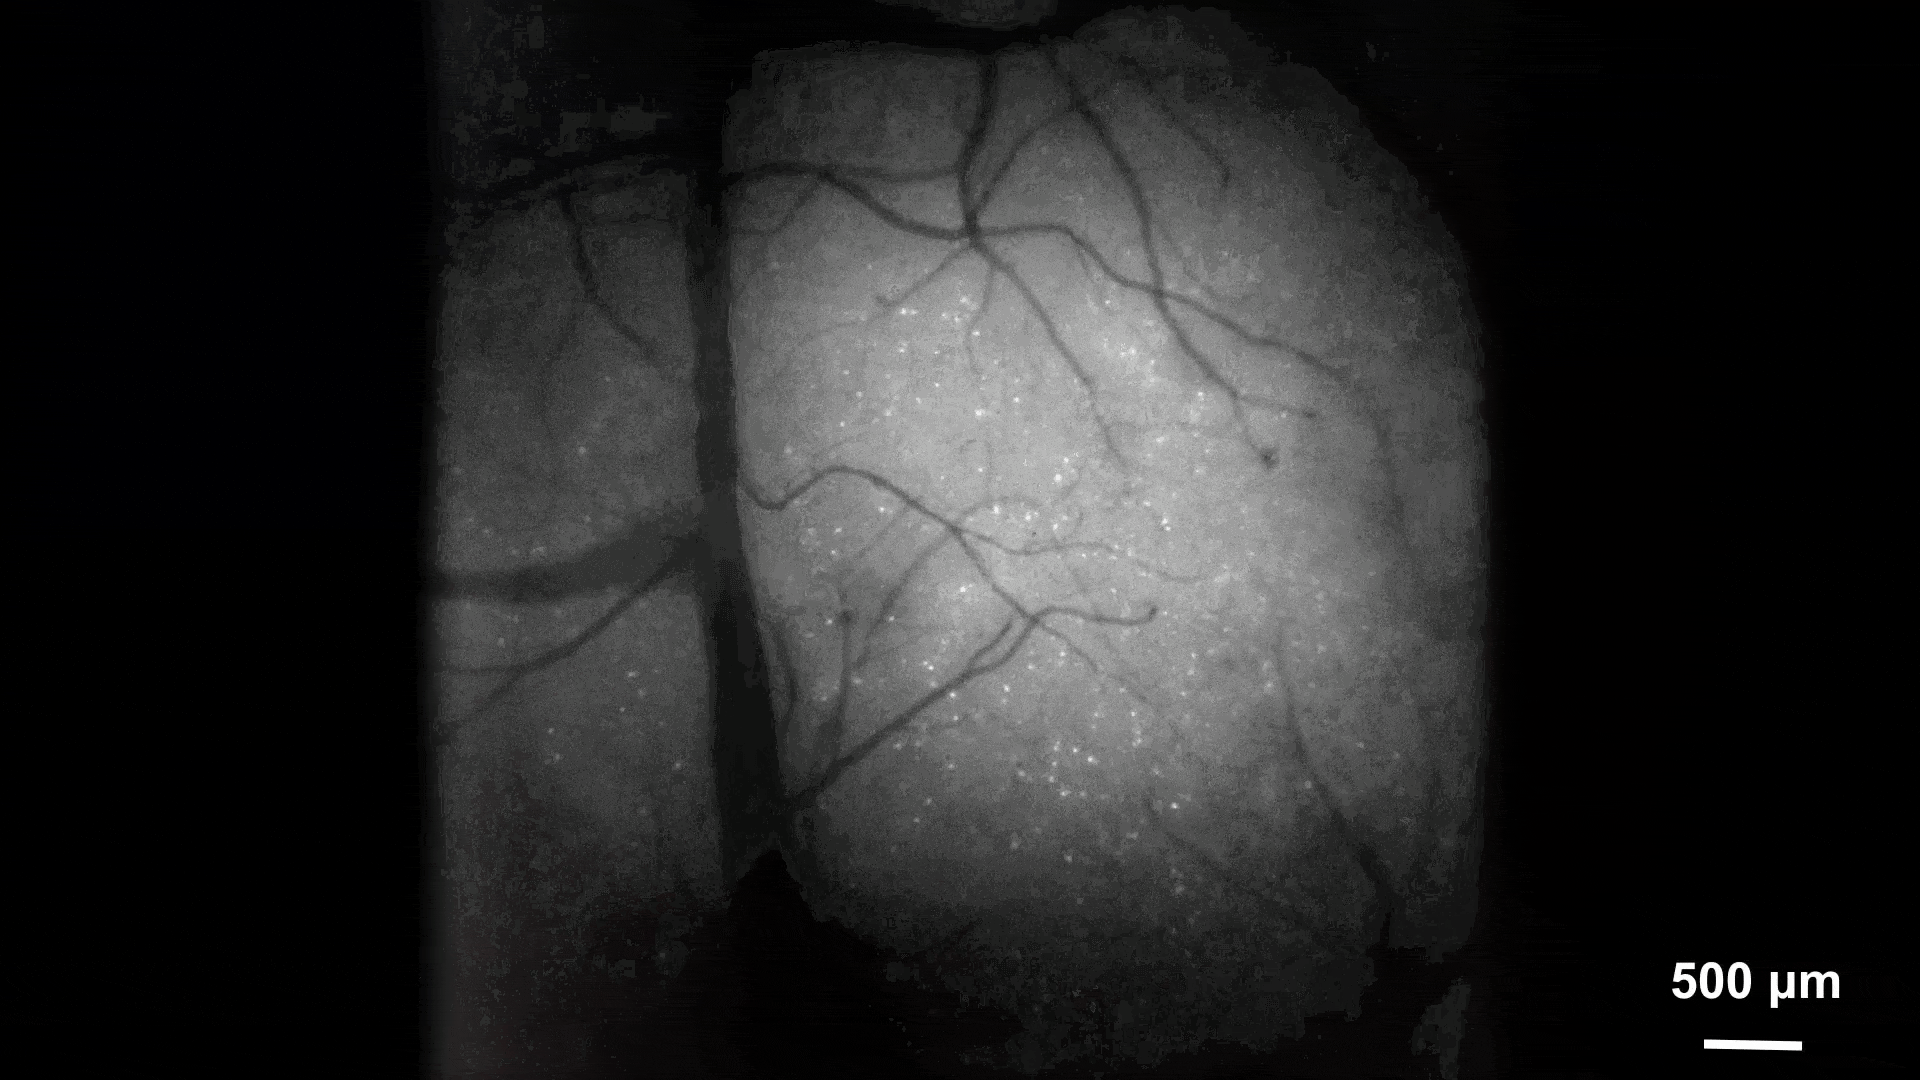
图为观测到的小鼠大脑神经元图像。(研究团队供图)
借助这种动物“可穿戴”设备,团队完成了许多过去受线缆或设备重量所限难以实现的实验,如在5平方米自然栖息地中同时记录多只小鼠探索时的大脑皮层活动;在32个末端的大型迷宫中追踪小鼠长时间自主探索等。
戴琼海认为,这一新型显微镜为理解智能的神经基础提供了新工具,将推动光学脑机接口向更精准神经探测发展,未来其应用还有望从神经科学拓展到免疫、肿瘤等领域,实现对疾病发生过程的完整追踪。(来源: 新华网)